LLM(大規模言語モデル)の学び方は、各段階で「何を正解・お手本・評価にして学ぶのか」に注目すると、区別しやすくなります。事前学習は文章の続き、教師ありファインチューニングはお手本の回答、RLHFは人の評価を手がかりにします。まずは、この代表的な流れを押さえます。
G検定とE資格を持つ私も、2027年2月の生成AIパスポートに向けて、同じ範囲を勉強しています。
この記事では、要約や申請メールの例で、3つの学び方を比べます。文章を生成する仕組みは後編に分け、今回は学習の違いに絞ります。
今回は第2章の学習プロセス|代表的な3段階を押さえます
2027年2月試験からの公式シラバスの第2章には、中項目「生成AIの学習プロセス」があります。学習項目は、事前学習・ファインチューニング・RLHF・学習データの規模と課題・スケーリング則の5つです。
シラバスでは、事前学習・ファインチューニング・RLHFの3段階で学習の流れを整理しています。ここでは、文章を生成するLLMを例に、事前学習→教師ありファインチューニング→RLHFの順で説明します。すべてのLLMが、必ずこの3段階を同じ方法で通るわけではありません。
学習データの規模と課題・スケーリング則は、学習に使う材料や規模の話です。とくにスケーリング則は、後半で事前学習の研究をもとに説明します。
前回「第4回で扱う」とした話題のうち、この記事ではLLMの学び方と、用途に合わせるための追加の学習を説明します。もう1つの文章の出し方(入力から1語ずつ出すまで)は、第4回後編で扱います。
図1 文章を生成するLLMの、代表的な学習の流れです
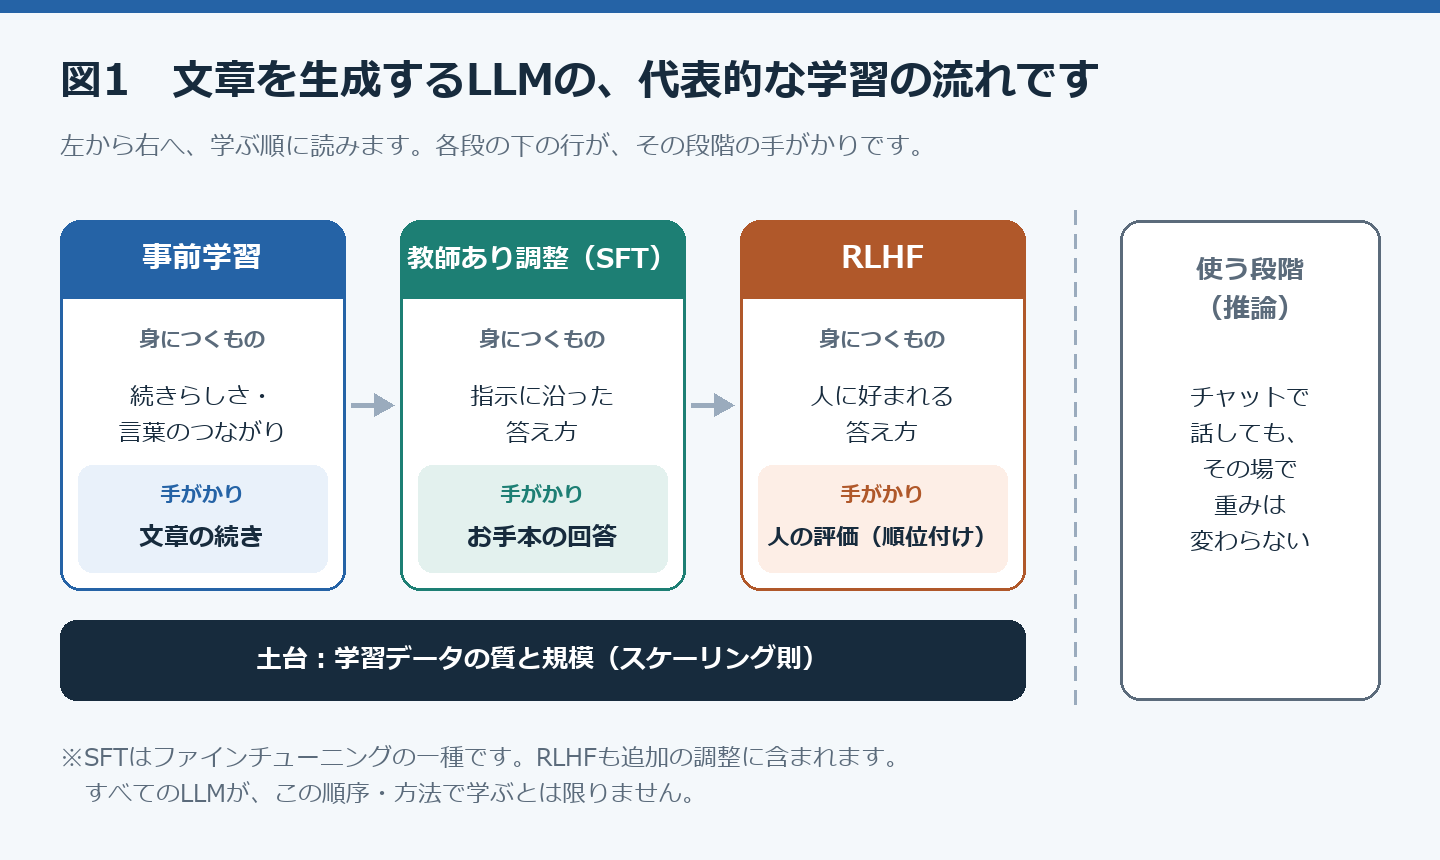
左から右へ、学ぶ順に読みます。各段の下の行が、その段階の手がかりです。
3つの段階は、どれもモデルの重みを変えるので「学習」です。できあがったモデルに質問して答えを得る段階は、第1回で区別した推論に当たります。
InstructGPTなどの代表例では、事前学習に大量の文章を使います。その後の段階では、比較的少量のお手本や評価データで答え方を調整します。
回答するLLM本体は、前の段階で得た重みを引き継いで調整します。RLHFでは、これとは別に、答えを評価する報酬モデルも作ります。
通常のチャットでは、会話したその場でLLMの重みを更新するわけではありません。直前に伝えた条件に沿って答えが変わるのは、その会話を入力として参照しているためです。会話を後のモデル改善に使うかどうかは、サービスや利用設定によって異なります。
事前学習は文章の続きを当てる練習|正解は文章そのものです
ここで扱う次トークン予測では、大量の文章そのものから、入力と正解の組を作ります。メールを「迷惑/通常」に分類する例のように、人が1件ずつ正解ラベルを付ける必要はありません。データ自身から正解を作るため、自己教師あり学習と呼ばれます。
ただし、文章を集め、品質や重複を確認する作業は必要です。人の手がまったくかからない、という意味ではありません。
図2 事前学習では、文章の続きのトークンを当てる練習をくり返します
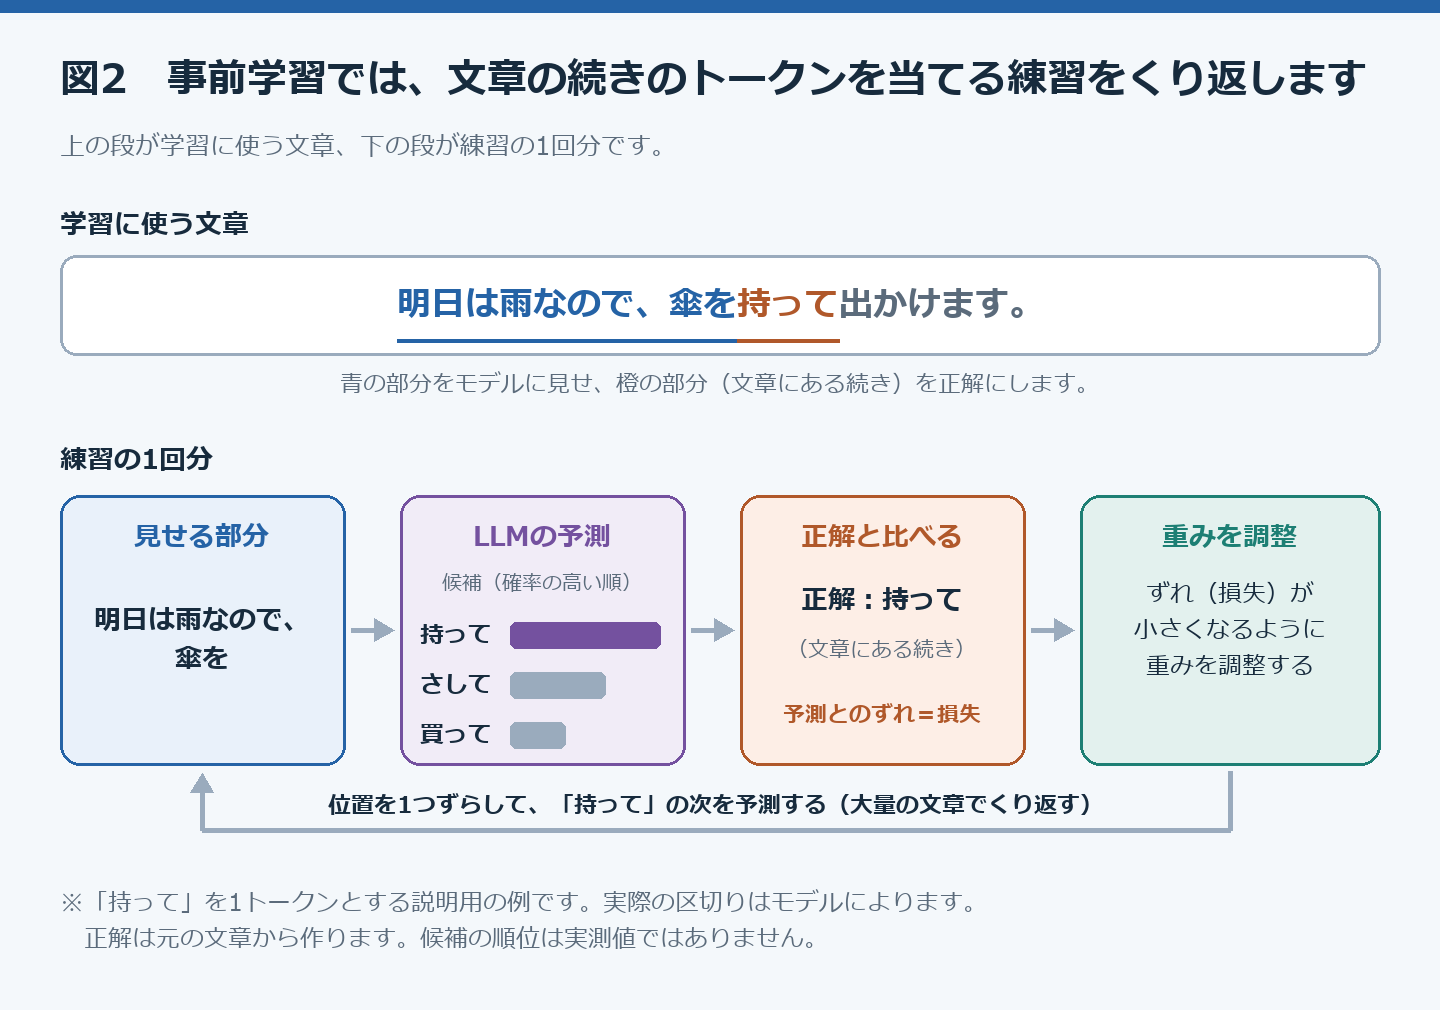
上の段が学習に使う文章、下の段が練習の1回分です。
次トークン予測では、文章にある続きのトークンが正解です
例文は「明日は雨なので、傘を持って出かけます。」です。モデルには「明日は雨なので、傘を」までを見せて、次に来るトークンを予測させます。図では説明のため、「持って」を1つのトークンとして扱います。この場合の正解は、文章に実際に書かれている「持って」です。実際の区切り方は、使うモデルによって異なります。
予測と正解のずれ(損失)が小さくなるように、モデルの重みを調整します。次は位置を1つずらし、「持って」の次を予測させます。この練習を、大量の文章でくり返します。図は1か所の予測を取り出した説明です。実際の学習では、複数の位置の予測をまとめて計算できます。
トークンは、文章を区切った単位です。単語や1文字と一致するとは限りません。文章をどう区切るか(トークン化)は、第4回後編で扱います。
第1回の迷惑メールの例では、人がメールごとに「迷惑/通常」のラベルを付けました。事前学習には、この作業がありません。
見分ける基準は、正解を人が付けるのか、文章にもともとある続きを使うのかです。
前回、多くのLLMは続きの語を1つずつ順に出すと書きました。次トークン予測の練習が、この出し方の元になっています。
パラメータは学習で調整される重み|生成パラメータとは別物です
第2回前編で、学習で値が調整される重みを説明しました。LLMでは、この重みなどの数値をパラメータと呼びます。LLMの「大規模」は、主にパラメータの数と、学習に使うデータの量が大きいことを指します。
パラメータを増やすと、より複雑な関係を表せる余地が広がります。ただし、パラメータの数だけで答えの正しさは決まりません。
名前の似ている生成パラメータは、モデルを使うときの設定です。Temperatureなどが当たり、値を変えても学習済みの重みは変わりません。生成パラメータの中身は、第4回後編で扱います。
事前学習で身につくのは続きらしさ|事実を検索してはいません
続きを当てる練習を大量の文章でくり返すと、モデルは語のつながり方や文法を身につけます。文章によく出てくる知識も身につきます。たとえば「日本の首都は」の続きとして、「東京」を高い確率で予測できるようになります。
ただし、事前学習は、事実を表のように保存して引き出す仕組みではありません。モデルは、文章として自然な続き(続きらしさ)を予測できるように学んでいます。答えるたびに外部の資料で事実を照合するわけではありません。
もっともらしいけれど事実と違う内容を出すことを、ハルシネーションと呼びます。続きらしさを学んだモデルは、文章としては自然な誤りも出せてしまいます。
ハルシネーションが起こる理由は、文章の出し方の側にもあります。両方をあわせた整理は、第4回後編で行います。
ファインチューニングは、学習済みのLLMを用途に合わせる追加の学習です
第2回前編では、ファインチューニングを、学習済みの重みを新しいデータに合わせて追加調整する方法として紹介しました。転移学習との関係は、生成AIパスポートのニューラルネットワーク(転移学習とファインチューニング)にあります。
LLMでも考え方は同じです。ファインチューニングは、学習済みのモデルを追加で調整する広い呼び名です。その代表例が、次に説明する教師ありファインチューニング(SFT)です。
教師ありファインチューニングと指示チューニングは、お手本の答え方をまねさせます
教師ありファインチューニングでは、入力と、お手本の出力を組にして学ばせます。ここでは、人が書いた模範解答を使う例で考えます。たとえば「この文を3行で要約して」という指示と、人が書いた3行の要約の組です。
事前学習の正解は、文章の続きでした。教師ありファインチューニングでは、用意したお手本の出力を正解にします。文章を出力するSFTでも、次のトークンを予測する計算を使います。違いは、学習に使うデータと、どんな答え方へ調整したいかです。
指示チューニング(Instruction Tuning)は、多くの種類の指示と答えの組で学ばせる方法です。学習で見ていない種類の指示にも、従いやすくすることを狙います。
指示チューニングは、教師ありファインチューニングの中でも、指示に従わせるためのものに当たります。教材によっては、2つをほぼ同じ意味で使います。
指示チューニングでは、要約する、質問に答えるなど、求められた形で応答することを学びます。LIMAの論文は、知識や能力の多くを事前学習で得て、その後の調整で答えの形式を学ぶという仮説を示しています。追加の学習では知識を身につけられない、と結論づけたものではありません。
ドメイン適応と追加学習は、分野の文章や新しいデータで学び直します
ドメイン適応は、医療や法律など、特定の分野(ドメイン)へモデルを合わせることです。その分野の文章を使って次トークン予測を続ける方法や、専門的な質問と答えの組で調整する方法があります。
追加学習は、学習済みのモデルに、あとからデータを足して学ばせることです。新しい時期の文章や、特定分野の文章などを使います。ただし、資料を質問と一緒に渡すだけなら、重みを変える追加学習とは別です。
ドメイン適応も追加学習も、学習済みの重みを出発点にします。モデルをゼロから作り直すわけではありません。
RLHFは、人の評価から作った報酬モデルで、好まれる答えに寄せます
RLHF(人間のフィードバックによる強化学習)は、「どちらの答えが良いか」という人の評価を手がかりにします。丁寧さや分かりやすさのように、お手本を1つに決めにくい良し悪しを、比べることで伝えます。
第1回の生成AIパスポートのAIの基本と歴史(強化学習と報酬)で出てきた「報酬」が、RLHFで使われます。シラバスの詳細キーワードは報酬モデルと人間の評価までで、強化学習の計算方法の名前は挙がっていません。
図3 RLHFは、人の順位付けを報酬モデルに学ばせてから使います
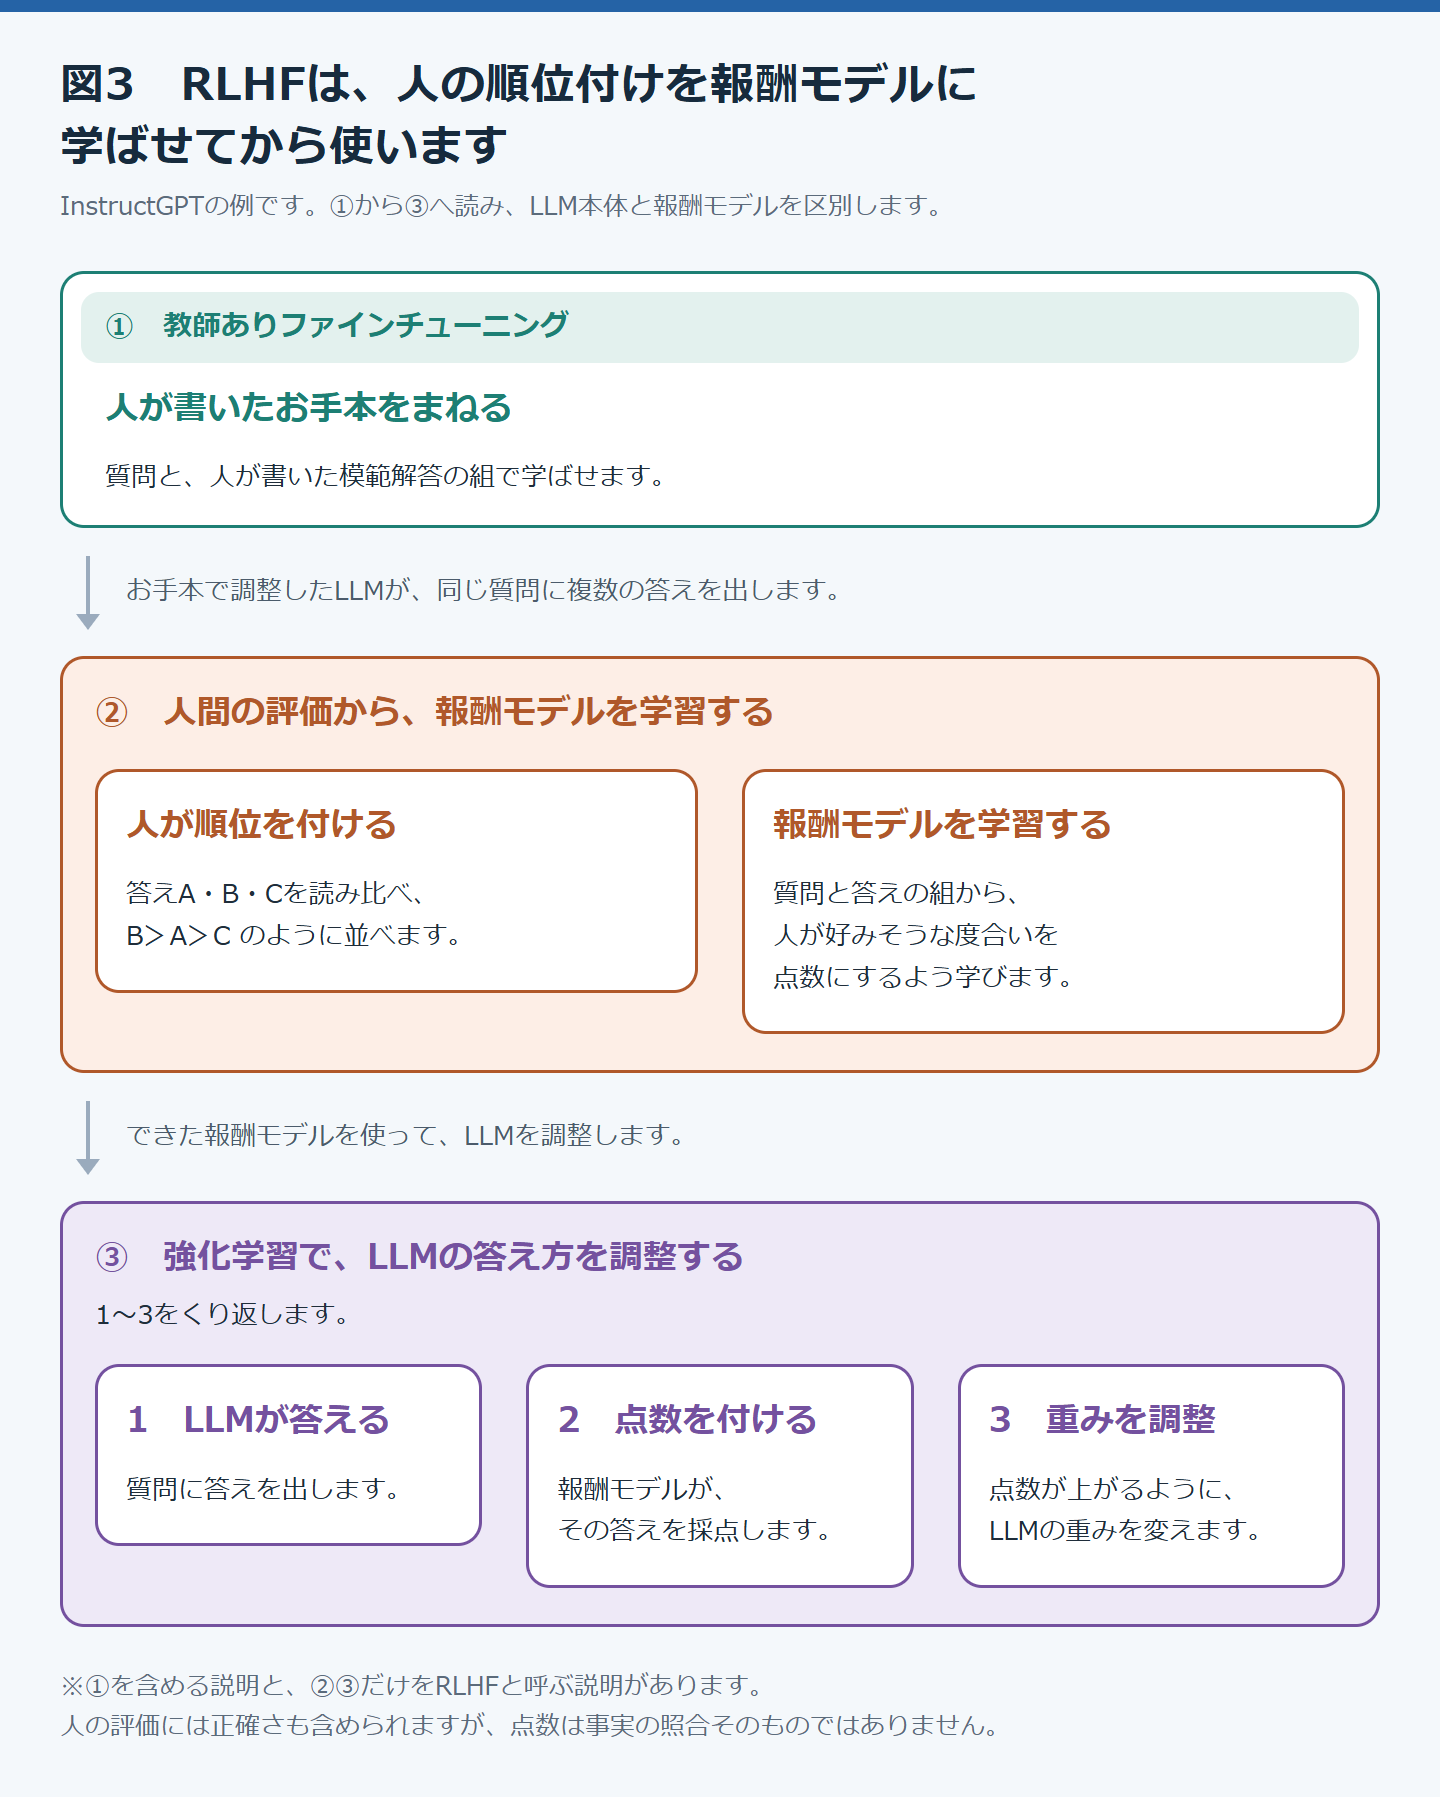
①から③へ順に読みます。①は前の節の教師ありファインチューニングです。
人間の評価では、同じ質問への複数の答えに順位を付けます
たとえば「有給休暇の申請メールを書いて」という質問に、モデルが答えA・B・Cを出します。人はこの3つを読み比べ、「B>A>C」のように順位を付けます。
見分ける基準は、人が答えを書くのか、人が答えを比べるのかです。
RLHFでは、人が毎回の答えを採点し続けるのではありません。集めた順位付けから、先に報酬モデルを作ります。
報酬モデルが答えに点数を付け、強化学習で答え方を調整します
報酬モデルは、質問と答えの組を受け取り、その答えが人の評価でどれくらい好まれそうかを点数にします。LLM本体とは別のモデルです。
強化学習の段階では、次の流れをくり返します。
- LLMが質問に答える
- 報酬モデルが、その答えに点数を付ける
- 点数が上がるように、LLMの重みを調整する
第1回では、報酬を「行動の結果に与える点数」と説明しました。RLHFでは、LLMが答えることが行動に、報酬モデルの点数が報酬に当たります。
人の評価には、丁寧さだけでなく、正確さや安全性も含められます。ただし、報酬モデルは人の評価を予測する仕組みです。高い点数でも、外部の資料で事実を確かめたことにはなりません。
RLHFもファインチューニングと同じく追加の学習|手がかりが違います
2022年のOuyangほかの論文(InstructGPT)は、教師ありファインチューニング→報酬モデルの学習→強化学習という3段で、GPT-3を調整しました。図3の①〜③が、この流れです。
そのため、RLHFの1段目に教師ありファインチューニングを入れて説明する教材や、RLHFをファインチューニングの一種と呼ぶ説明もあります。シラバスでは、ファインチューニングとRLHFは別の学習項目です。
教材の説明がどちらでも、RLHFとファインチューニングは、ともに学習済みの重みを調整します。この記事で比べるのは、お手本を使うSFTと、人の比較評価を使うRLHFです。どちらも広い意味では、学習済みモデルを追加で調整する方法に含まれます。
ChatGPTなどのサービスにRLHFがどう使われているかは、第5回で扱います。
学習データは量と質の両方が効く|規模と性能の関係はスケーリング則
ここまでの3つの段階は、どれもデータから学びます。どんなデータを集めるかと、モデルをどこまで大きくするかは、どの段階の結果にも関わります。
データの誤りや偏り(バイアス)は、モデルの出力にも影響します
学習データは、多ければ良いわけではありません。誤った内容や同じ文章の重複、質の低い文章が多いと、モデルはそれも学びます。データの品質を上げるため、学習の前にこうした文章を減らします。
バイアスは、データやモデルの出力に表れる偏りです。たとえば「看護師は女性」のような書き方が多い文章を学ぶと、出力にも同じ偏りが表れるおそれがあります。RLHFでは、評価する人の好みから偏りが入ることもあります。
データの偏りは、誰かの悪意がなくても、文章に多い書き方から入ります。
学習データに著作物が含まれることも、課題の1つです。法的な扱いは、第11回で説明します。
スケーリング則は、規模を増やすと損失が規則的に下がる経験則です
ここでの規模は、パラメータの数・データの量・学習に使う計算量です。損失は予測のずれで、第2回前編の損失関数で求める値です。2020年のKaplanほかの論文が、規模と損失のこの関係を示しました。
図4 規模と損失の関係を示す説明用のグラフ
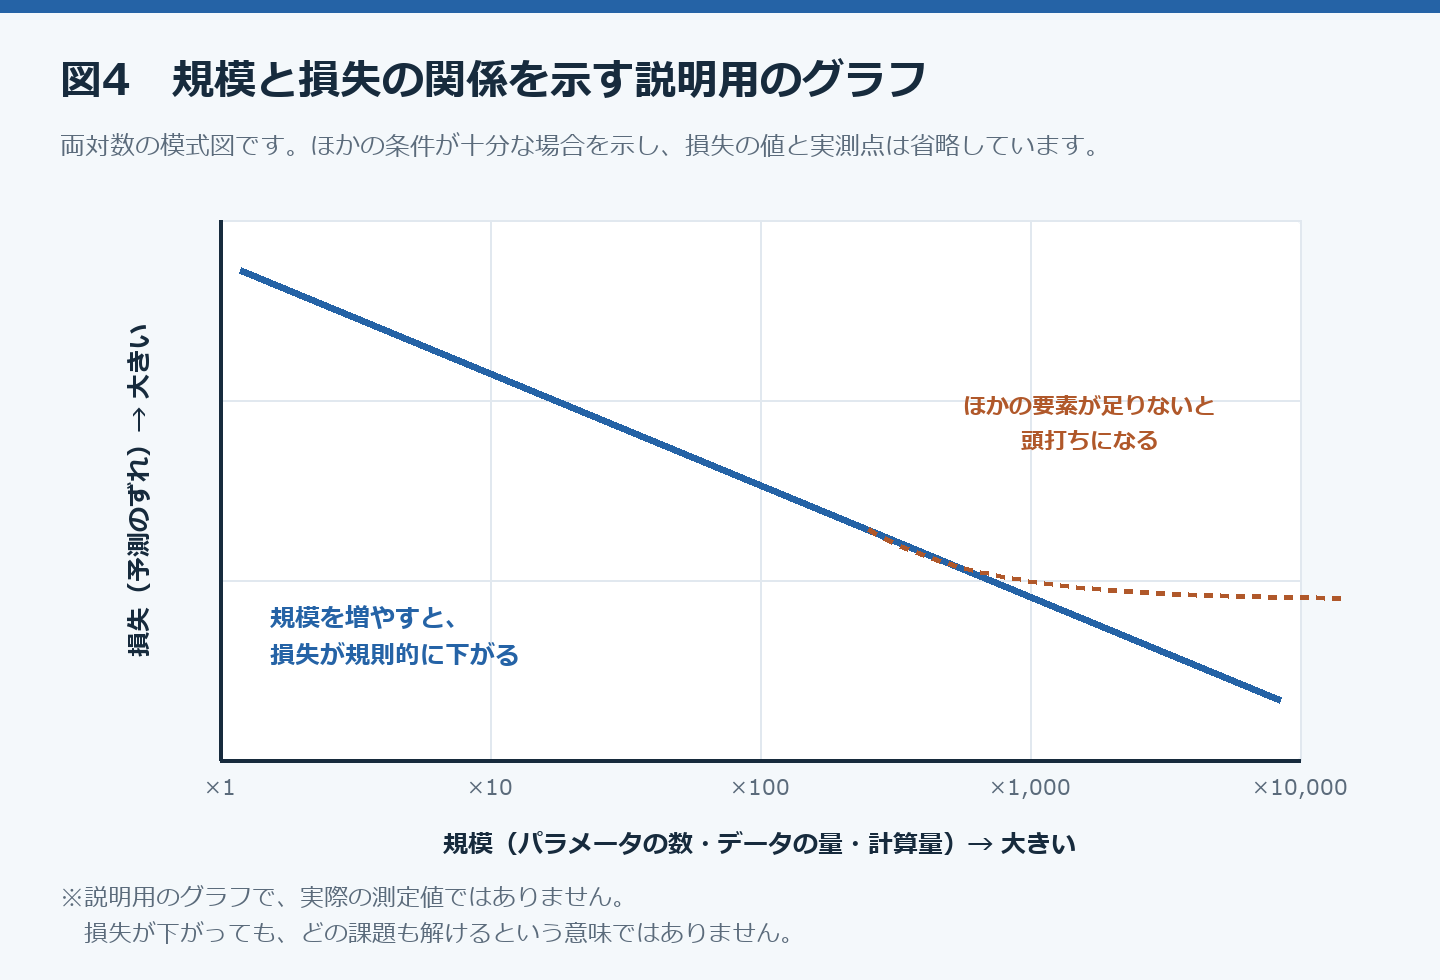
横軸は規模、縦軸は損失です。規模は、モデルの大きさ・データ量・計算量のいずれかに着目します。両方の軸を対数目盛りにすると、べき乗則の関係は直線で表せます。図はその形を示す模式図で、損失の数値や実測点は示していません。
この関係には前提があります。ほかの要素が足りないと、損失の下がり方は頭打ちになります。たとえば、データの量を増やさずにパラメータの数だけ増やしても、損失は下がり続けません。
損失が下がることと、どんな課題も解けるようになることは、別の話です。
創発的能力は、規模が大きくなると急に現れるとされる能力|詳しくは第5回
小さいモデルではほとんどできない課題が、ある規模を超えると急にできるようになる例があります。2022年のWeiほかの論文は、これを創発的能力と呼びました。
一方で、2023年のSchaefferほかの論文は、急に現れるように見えるのは評価の測り方によるものだと指摘しています。そのため、成績が急に上がって見えるときも、評価方法の影響を分けて考える必要があります。規模を大きくすれば必ず新しい能力が突然現れる、とは言い切れません。
LLMの特性としての創発的能力は、第5回で扱います。
チャットAIに架空の用語を説明させ、答え方を確かめます
チャットAIで新しいチャットを開き、次の文を送ってください。
「段落反転学習法」という学習方法を、Web検索を使わずに3行で説明してください。「段落反転学習法」は、この確認のために作った架空の語です。Web検索を使ったかは、検索中の表示が出たかで確かめます。本文にURLが書かれているだけでは、検索したとは限りません。
架空の語に、実在する確立した方法であるかのような説明が返れば、「文章として自然な誤り」の例になります。一方、「名前からの推測です」と断って説明する答えは、存在を事実として言い切る答えと区別します。
「そのような学習方法は見当たりません」のように返ることもあります。どの答えでも、AIの説明が正しいかを自分で確かめる必要は変わりません。
私がChatGPTで試したときは、「確立された学習方法は確認できませんでした」と返り、名前から推測した説明が「推測」と断ったうえで続きました。1回の結果だけで、そのモデル全体の性質は決められません。使うモデルや設定によって、結果は変わります。
この試し方で観察できるのは、架空の語への応答です。事前学習だけの影響を切り分ける実験ではありません。SFTやRLHF、入力した指示なども答え方に関わります。
確認問題で、事前学習・RLHF・スケーリング則を確かめます
以下は、この記事の復習用に作った問題です。
Q1. 事前学習の次トークン予測で、正解として使うものはどれですか。
- A. 人が文章ごとに付けた「正しい/誤り」のラベルです。
- B. 検索エンジンで調べた結果です。
- C. 学習に使う文章にある、実際の続きのトークンです。
- D. 報酬モデルが付けた点数です。
答えはCです。各段階が何を手がかりにするかを問う問題です。事前学習では、文章にもともとある続きを正解にします。Aは、第1回の迷惑メールのように、人がラベルを付ける学習と混同しています。Bは、事前学習の中で外の資料を検索していると取り違えています。Dは、RLHFで使う手がかりです。
Q2. RLHFの報酬モデルを学習させる際に、人が行う作業として正しいものはどれですか。
- A. 同じ質問への複数の答えを読み比べ、順位を付けます。
- B. LLMが答えるたびに、その答えを採点し続けます。
- C. 質問と模範解答の組を書きます。
- D. LLMの重みを手で書き換えます。
答えはAです。報酬モデルを作るときの、人の役割を問う問題です。人が付けた順位から報酬モデルを作り、その後の点数は報酬モデルが付けます。Bは、報酬モデルが点数を付ける点を取り違えています。Cは、教師ありファインチューニングで人がする作業です。Dは、重みを強化学習で調整する点を取り違えています。
Q3. スケーリング則の説明として正しいものはどれですか。
- A. パラメータを増やせば、どの課題も必ず解けるようになります。
- B. 規模がある大きさを超えると、必ず新しい能力が現れます。
- C. データの量は、減らすほど性能が上がります。
- D. パラメータの数・データの量・計算量を増やすと、損失が規則的に下がるという経験則です。
答えはDです。スケーリング則の中身と前提を問う問題です。スケーリング則は損失の下がり方を表し、ほかの要素が足りないと下がり方は頭打ちになります。Aは、損失が下がることを、どの課題も解けることと同じに扱っていて、言い切りすぎです。Bは、創発的能力と混同しています。創発的能力には、評価の測り方による見かけだという指摘もあります。Cは、増やすと下がるという向きが逆です。
関連記事:会話を学習に使う設定の止め方は、私が実際の画面で確かめて、Codexに学習させない設定は2か所|ChatGPTとCodexの画面で確認にまとめました。
まとめ
代表的なLLMの学習では、事前学習で文章の続き、SFTでお手本の回答、RLHFで人の評価を手がかりにします。回答するLLM本体の重みを引き継ぎながら、答え方を調整します。
お手本や人の評価に、事実の正確さを含めることもできます。それでも、学習済みのモデルが出す答えを、そのまま事実とみなすことはできません。重要な内容は、出典と照らして確かめます。
生成AIパスポートに向けて、3つの段階の手がかりを、それぞれ1文で言えるか確かめてください。言えない段階があれば、図1に戻ると良いです。
第4回後編では、学んだモデルがどうやって文章を出すのか(トークン化から1語を選ぶまで)を扱います。連載の順番は、生成AIパスポートの勉強方法にあります。
出典・参考資料(2026年10月22日確認):
- 対象範囲は、生成AIパスポート試験シラバスを確認しました。
- 教師ありファインチューニング・報酬モデル・強化学習の流れは、Ouyangほかの論文(InstructGPT・英語)を参照しました。
- 指示チューニングは、Weiほかの論文(FLAN・英語)を参照しました。
- スケーリング則は、Kaplanほかの論文(英語)を参照しました。
- 創発的能力は、Weiほかの論文(英語)と、Schaefferほかの論文(英語)を参照しました。
- 指示チューニングで身につくものは、Zhouほかの論文(LIMA・英語)を参照しました。
- 「大規模」の意味と学習データの品質は、Zhaoほかのサーベイ(英語)を参照しました。
- 会話と学習の関係は、OpenAIのヘルプ「How your data is used to improve model performance」(英語)を確認しました。

コメント