CNNは画像の近くの画素をまとめて扱い、RNNは順番に沿って情報を受け渡します。VAEとGANは、新しいデータを作る仕組みが異なります。まずは、それぞれの計算の特徴を具体例で押さえます。
私はG検定とE資格を持っていて、2027年2月に生成AIパスポートを受験する予定です。この連載は、私自身の受験勉強も兼ねています。
例には、前編と同じ迷惑メールの判定と花の写真を使います。あわせて、RNNの弱点からLSTM、さらにTransformerへつながる流れも整理します。
今回は第1章「ニューラルネットワーク」の後半6項目を扱います
2027年2月試験からの公式シラバスには、第1章の中項目「ニューラルネットワーク」に学習項目が11あります。今回は、その後半の6項目が対象です。
- CNN:画像の近くの画素をまとめて読みます。
- RNN:順番のあるデータを1つずつ読みます。
- LSTM:RNNの一種で、前の情報を長く残します。
- VAE:データの特徴を確率的に表し、そこから新しいデータを作ります。
- GAN:作る側と見破る側を競わせて、新しいデータを作ります。
- 識別系AIと生成系AIの違いは、判定する役割か、新しいデータを作る役割かで整理します。
この記事は、前編で扱った層・重み・誤差逆伝播法を土台にします。Attention・Transformerはこの記事では位置づけだけにして、仕組みは第3回で説明します。
CNNは畳み込みで、画像の近くの画素から特徴を拾います
前編の迷惑メールは、「当選」という語の有無やリンクの数を数値にして並べた入力でした。写真は画素が縦横に並び、近くの画素どうしが線や模様を作ります。CNN(畳み込みニューラルネットワーク)は、この「近さ」を生かすモデルです。
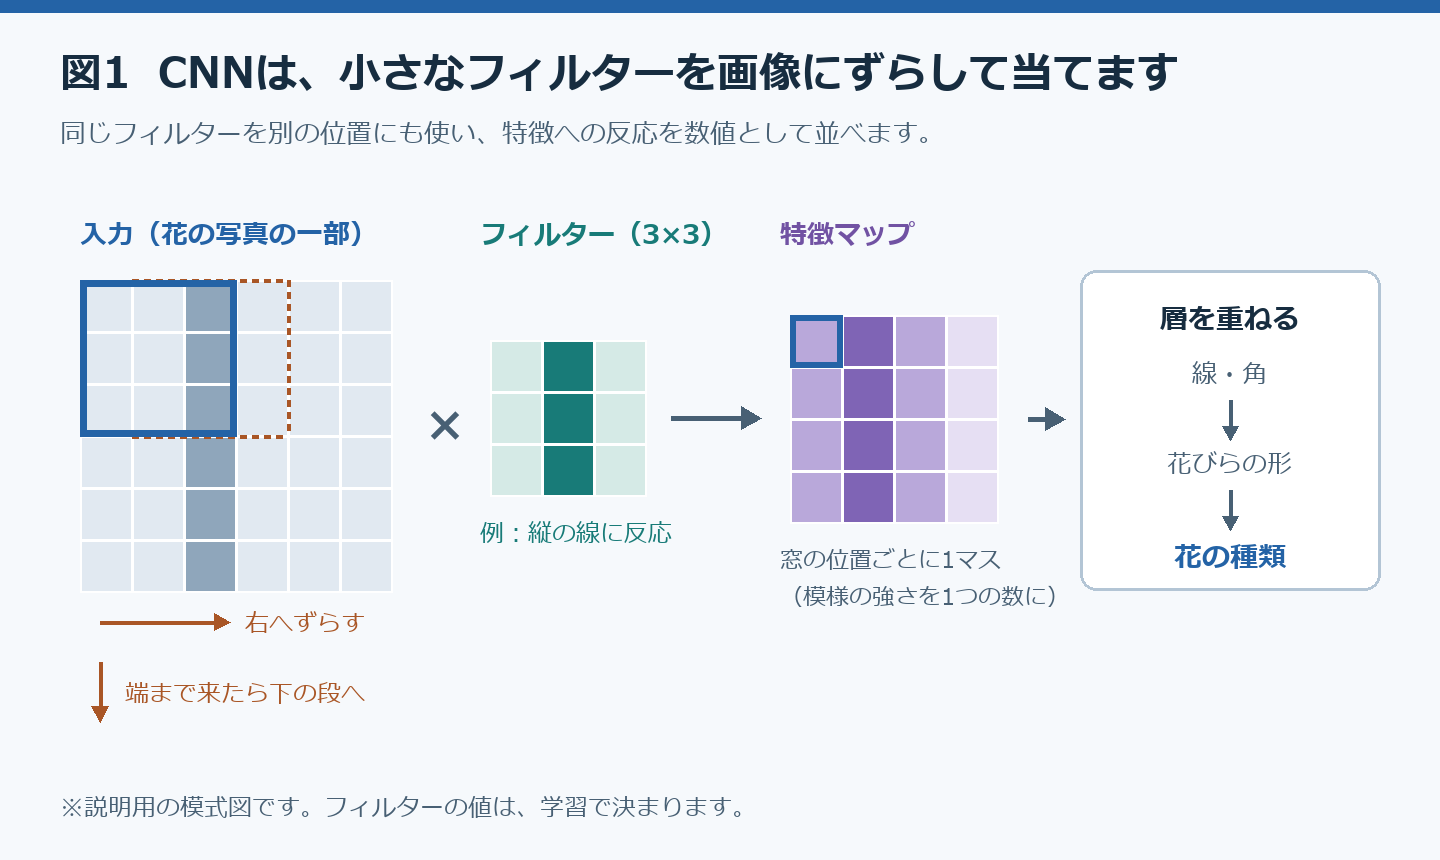
畳み込みでは、小さなフィルターを画像全体にずらして当てます
花の写真を判定する例では、3×3などの小さなフィルターを、写真の上で少しずつずらします。フィルターは、重みを格子状に並べたものです。重なった画素の値と重みを掛け合わせ、足した結果を出します。
同じフィルターを別の位置にも使うため、写真のどこにある特徴も、共通の計算で探せます。各位置の計算結果を並べたものが、特徴マップです。
浅い層では、線や角のような小さな特徴を捉えます。層を重ねると、それらを組み合わせた花びらの形なども捉えられます。
フィルターの値も、学習で調整する重みです。「縦の線に反応する」といった働きも、学習の結果として得られます。
CNNは写真の判定などコンピュータビジョンで使われます
コンピュータビジョンは、画像や映像から内容を読み取る分野です。花の種類の判定も、この分野の課題です。
第1回で触れた2012年の画像認識の競技会で、高い成績を出した手法もCNNでした。
RNNは順番に読み、LSTMは前の情報を長く残します
文章は、単語の順番が意味を決めます。
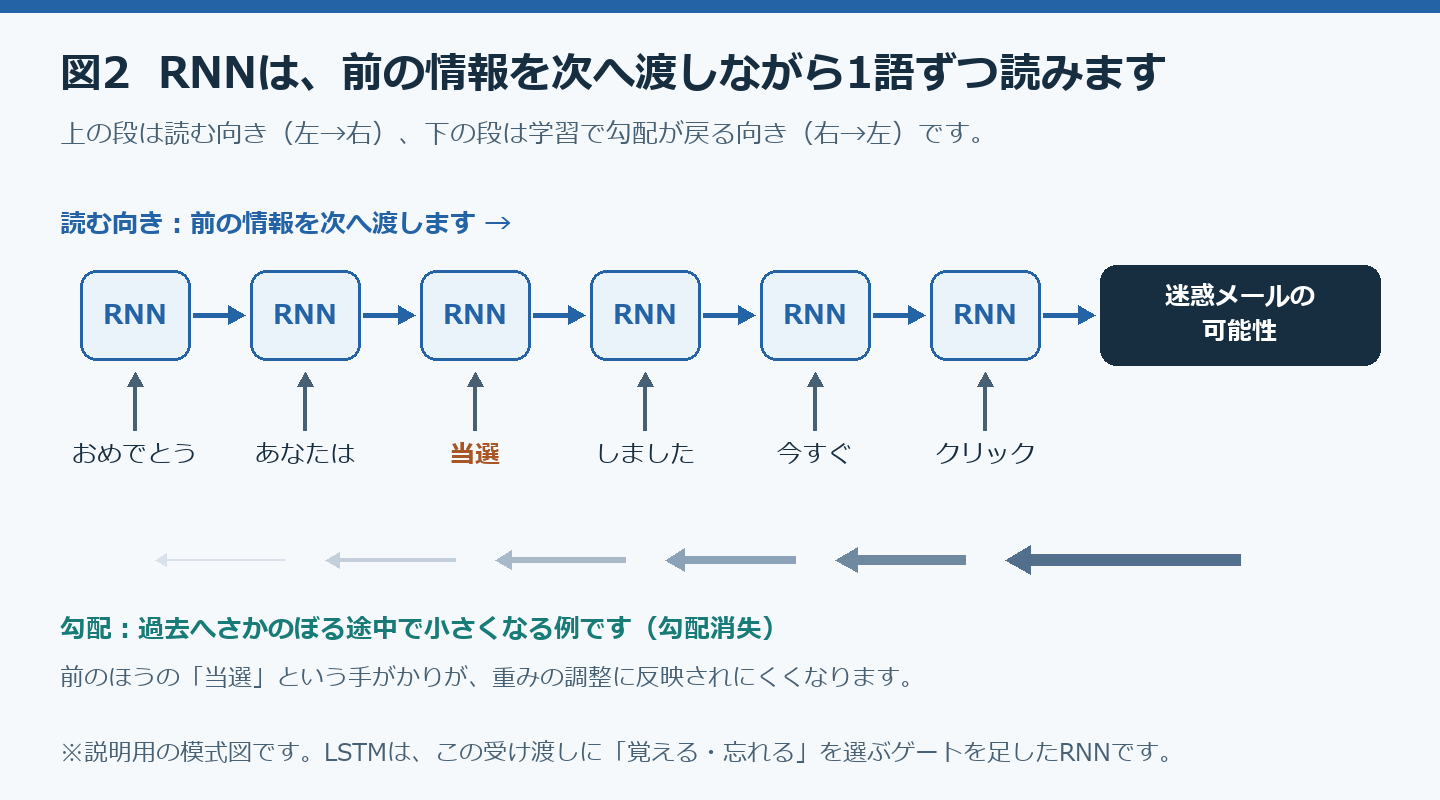
RNNは、前の単語の情報を持ち越しながら1語ずつ読みます
RNN(再帰型ニューラルネットワーク)では、前の時点の情報を、隠れ状態と呼ぶ数値の組で次へ渡します。迷惑メールの本文なら、説明のため「おめでとう」「あなたは」「当選」のように区切って考えます。
次の語を読むときは、その語だけでなく、それまでの隠れ状態も使います。この例では、最後まで読んだ結果から迷惑メールの可能性を出します。実際の文章は、文字や単語の一部などに分けて処理することもあります。
文章・音声・株価のように、順番に意味がある並びをシーケンスデータと呼びます。CNNが画像の「近くの並び」を読むのに対して、RNNは「順番の並び」を読みます。
長い文では勾配が前まで届きにくい|勾配消失と勾配爆発
前編の誤差逆伝播法では、出力側から前の層へさかのぼって勾配を求めました。勾配の意味は、生成AIパスポートのニューラルネットワーク(前編・誤差逆伝播法)で説明しています。
RNNの学習でも、この判定例では、最後の出力から前の時点へさかのぼって勾配を求めます。その途中で小さな値を繰り返し掛けると、勾配が非常に小さくなることがあります。文の前のほうの手がかりが、重みの調整に反映されにくくなります。これが勾配消失問題です。
たとえば、冒頭の「当選」が迷惑メールの手がかりでも、文が長いと、その手がかりを学びにくくなります。
反対に、さかのぼるうちに勾配が大きくなりすぎて、学習が不安定になることもあります。これが勾配爆発問題です。勾配消失も勾配爆発も、長い文や層の深いネットワークで起きやすくなります。
勾配消失は、前の情報に関わる学習が進みにくくなる問題です。過学習は、学習データに合わせすぎる問題なので、区別します。
LSTMはRNNの一種で、覚える・忘れるをゲートで選びます
LSTMはRNNの一種です。情報を保持する経路と、その経路に何を残すかを調整するゲートを持ちます。ゲートは、情報をどれくらい通すかを計算で調整する仕組みです。人が記憶する語を指定するわけではありません。
この工夫で、離れた時点の関係を学びやすくします。長い情報を必ず覚えられるわけではなく、勾配爆発などがすべて解消するわけでもありません。
迷惑メールの例なら、冒頭の「当選」を文末まで持ち越しやすくなります。1語ずつ順番に読む点はRNNと同じで、違うのは前の情報の持ち越し方です。
TransformerはAttentionで、離れた語の関係を計算します
RNN・LSTMでは、前の時点の隠れ状態を受け取ってから次を計算します。Transformerは、この受け渡しを繰り返す代わりに、Attentionで離れた語の関係を計算します。
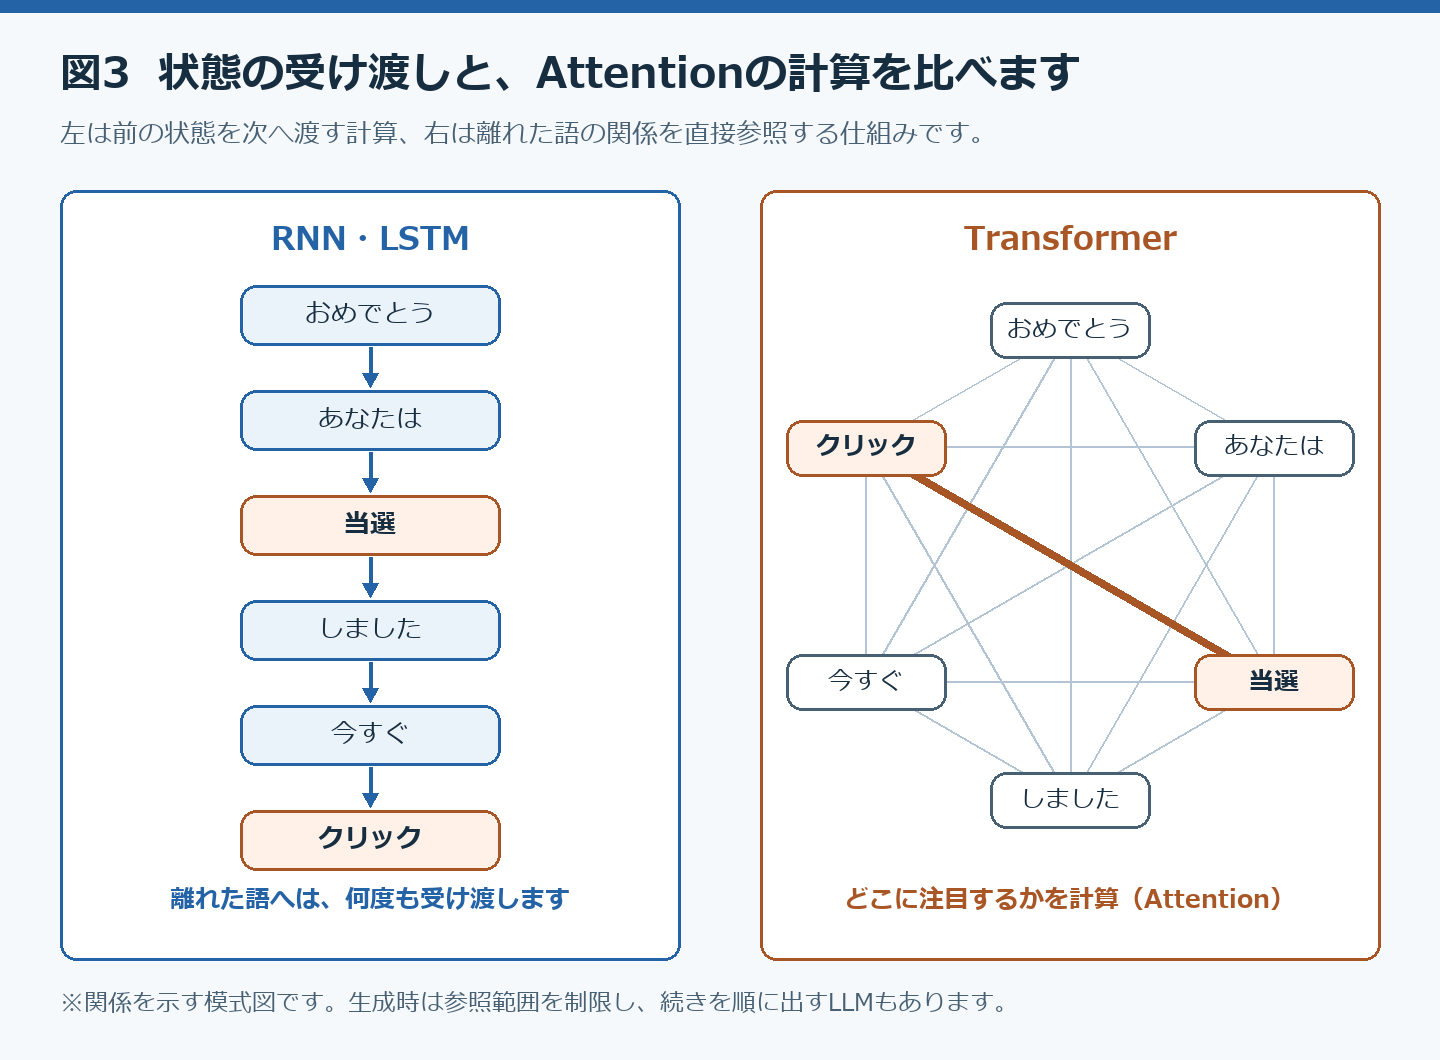
Attentionは、参照する情報に重みを付け、どの部分を強く使うかを計算する仕組みです。翻訳なら、ある訳語を出すとき、原文のどの部分を参照するかを計算します。代表的な初期の論文(2014年)では、RNNと組み合わせて使われました。
Transformerは、2017年の論文で提案されました。図3の太い線は、離れた「当選」と「クリック」の関係も計算できることを示します。説明用の線で、実際のモデルが出した注目度ではありません。
Transformerは、RNNのような隠れ状態の順次更新を使わない設計です。ただし、語順を無視するわけではなく、位置の情報も使います。
学習時には複数の位置の計算をまとめて進めやすい一方、多くのLLMが文章を生成するときは、続きの語を順に出します。「Transformerなら文章も一度に全部出す」という意味ではありません。
今の多くのLLM(大規模言語モデル)の土台は、Transformerです。Self-Attentionなどの仕組みは、第3回で扱います。
VAEは圧縮して戻し、GANは作る側と見破る側を競わせます
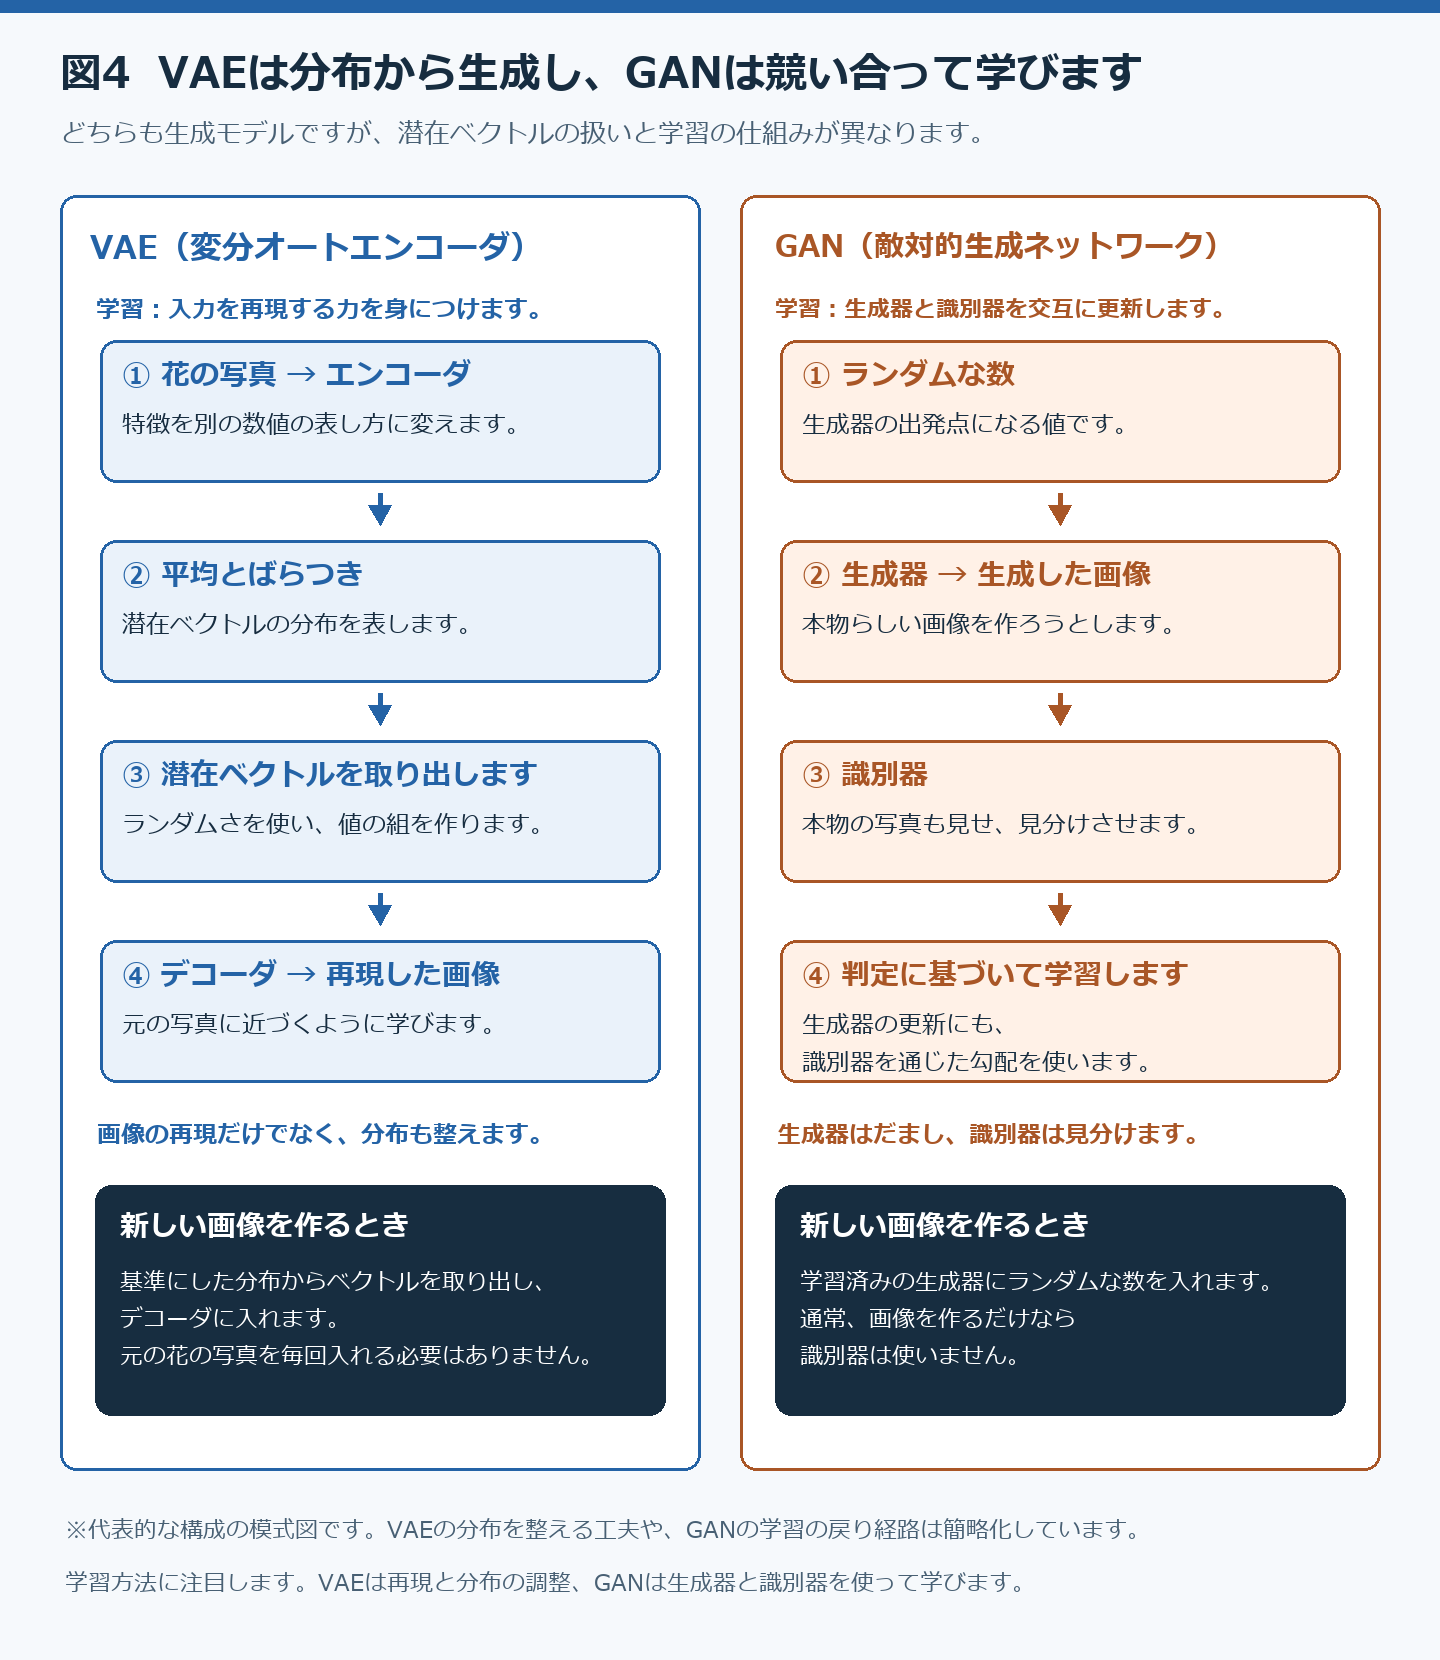
VAEとGANは、どちらも新しいデータを作る生成モデルです。VAEは潜在ベクトルの確率的な表し方を学び、GANは生成器と識別器を競わせます。
VAEは、潜在ベクトルを確率的に扱います
基本的なオートエンコーダは、入力の特徴を数値の組にまとめ、そこから入力を再現するように学びます。この数値の組が潜在ベクトルです。特徴をまとめる側をエンコーダ、元のデータの形へ戻す側をデコーダと呼びます。
VAE(変分オートエンコーダ)では、エンコーダは一つのベクトルだけを決めません。代表的な構成では、潜在ベクトルの各値について、平均とばらつきを求めます。どの値がどれくらい出やすいかを表すのが、確率分布です。そこからランダムに値を取り出し、デコーダで画像を再現します。
学習では、元の画像を再現することに加え、潜在ベクトルの分布を決められた分布に近づけます。この工夫があるため、新しく取り出したベクトルからも画像を作りやすくなります。単に圧縮した値へノイズを足すだけのモデルではありません。
新しい花の画像を作るときは、学習で基準にした分布から潜在ベクトルを取り出してデコーダに入れます。生成のたびに、元になる花の写真をエンコーダへ入れる必要はありません。
学習した潜在空間では、近いベクトルから似た画像が得られることがあります。ただし、どんな値を入れても意味のある画像になるとは限りません。
VAEと拡散モデルは、どちらもランダムさを使いますが、仕組みが違います。ここで説明したVAEは、取り出した潜在ベクトルをデコーダに通します。拡散モデルは、ノイズを段階的に取り除きながら画像を作ります。
エンコーダ・デコーダという語は、Transformerの説明にも出ます。同じ名前でも、VAEと同じ構造や計算をするとは限りません。
私はE資格の勉強で、VAEを数式で追いました。この記事では式は使わず、エンコーダ・潜在ベクトル・デコーダの役割を区別できるところまでを目指します。
GANは、生成器と識別器を競わせて本物らしさを高めます
GAN(敵対的生成ネットワーク)では、生成器(Generator)がランダムな数から偽物の画像を作ります。識別器は、見せられた画像が本物の写真か、生成器が作った偽物かを見分けます。
生成器は識別器をだませるように、識別器は本物と生成画像を見分けられるように学びます。生成器を調整するときは、識別器の計算を通じて得た勾配を使います。単に「正解・不正解」という判定だけを渡すわけではありません。
基本的なGANでは、2つを交互に更新します。生成器と識別器は、贋作を描く人と、それを見破る鑑定士の関係に似ています。学習後に画像を作るだけなら、通常は生成器を使います。
識別器は、GANの中で見分ける役を担う部品です。
VAEは画像がぼやけやすく、GANは学習が不安定になりやすい傾向があります
従来の基本的な構成を比べると、VAEには画像がぼやけやすい傾向があります。GANは鮮明な画像を作れる一方で、学習が安定しない場合があります。似た画像ばかり作るモード崩壊も、その一つです。画質や安定性は、モデルの構成や学習条件によって変わります。
VAEに近い仕組みのエンコーダ・デコーダは、今の画像生成AIの一部(潜在拡散モデル)でも使われています。潜在拡散モデルは、第3回で扱います。
識別する役割と、生成する役割を分けて考えます
シラバスの区分は、典型的な仕事に置き換えると理解しやすくなります。迷惑メールかどうかや花の種類を判定するのが、識別系の例です。花の画像や文章を新しく作るのが、生成系の例です。
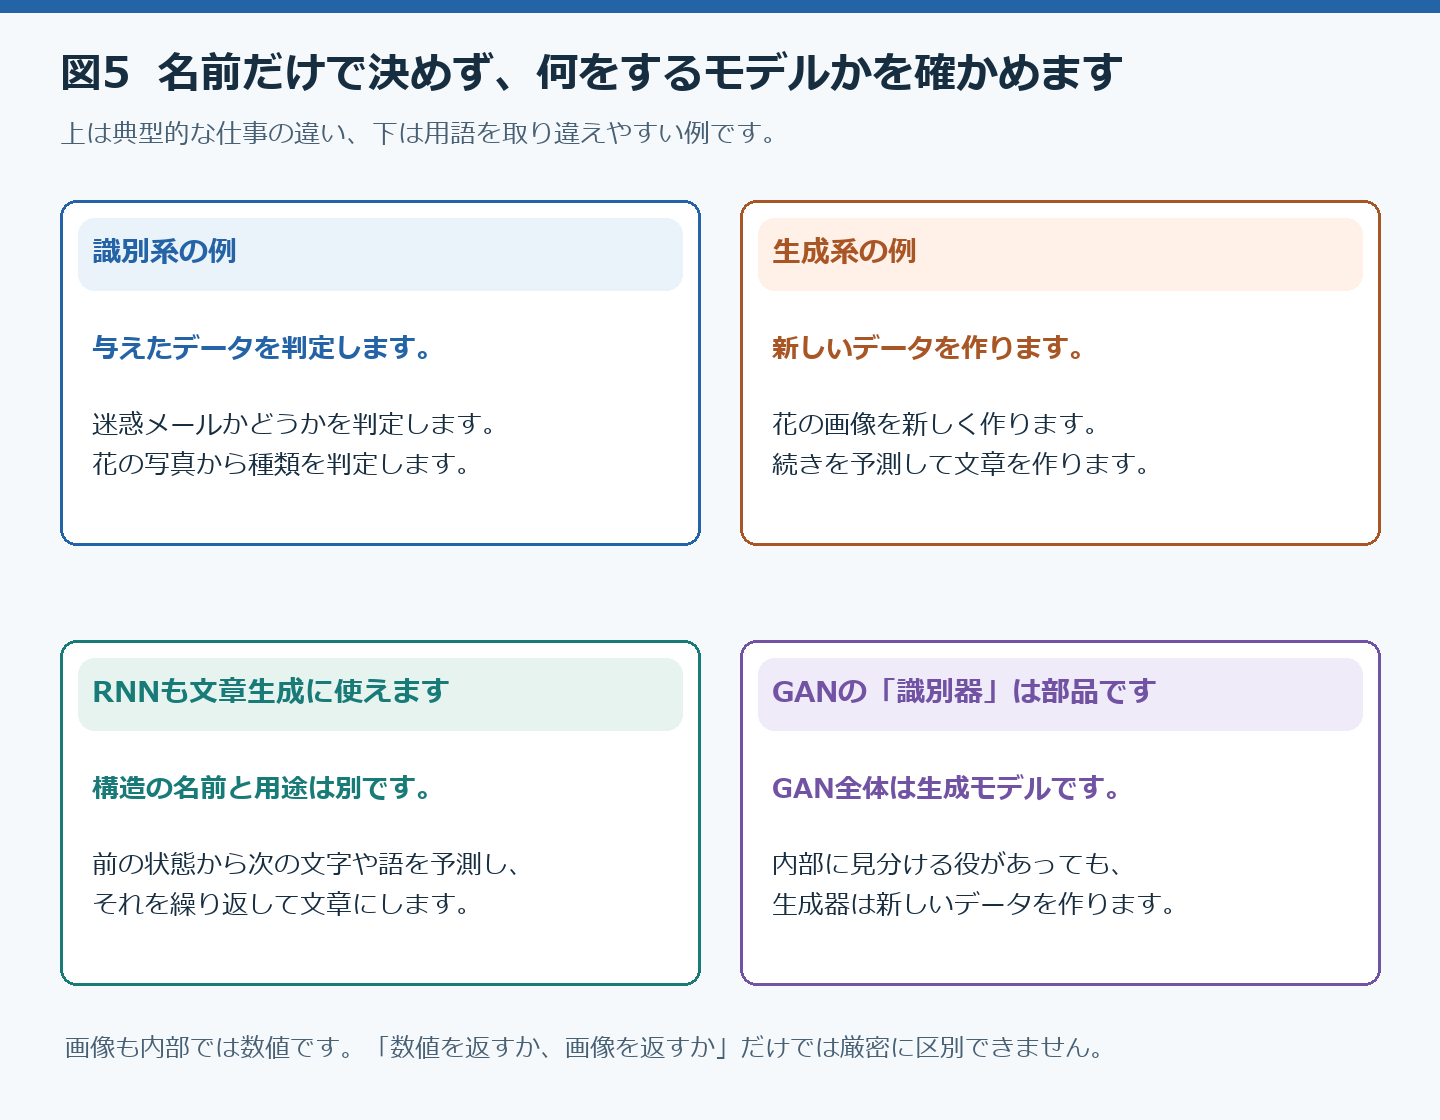
ただし、出力が数値かどうかだけでは区別できません。画像も内部では数値で表されます。売上の予測は回帰として整理でき、種類を判定する分類とも区別します。この記事では、名前の暗記より、何をするためのモデルかを確かめます。
モデル名だけでは決まらない|RNNは文章の生成にも使えます
RNNは、次に来る単語を予測して1語ずつ並べれば、文章を作れます。この使い方なら、RNNは生成系AIとして働きます。CNN・RNNは識別系でよく使われますが、それだけで識別系と決まるわけではありません。
GANの識別器は部品の名前で、GAN全体は生成系AIです
GANの識別器も、本物か偽物かを見分けます。ただ、GANを使って最後に得るものは、生成器が作った新しい画像です。
「識別器」はGANの中の部品の名前で、「識別系AI」はAIの分類の名前です。
AIで人物の顔や声などを合成・改変し、本物らしく見せる技術や生成物は、ディープフェイクと呼ばれます。必ずしもGANだけで作るものではありません。リスクと対策は、第4章を扱う第10回で説明します。
チャットAIに場面を出題させ、4つのモデルを見分けます
次の文を、使っているチャットAIに送ってみてください。
CNN・RNN(LSTM)・VAE・GANのどれが合うかを当てる場面を、名前を伏せて順番を混ぜ、4つ出してください。私が答えたあとで、正解と理由、識別系か生成系かを教えてください。私がChatGPTで試したときは、4つの場面が出ました。製品の画像から傷を見つける、過去30日の売上から翌日を予測する、実在しない人物の顔写真を作る、手書き数字の特徴を圧縮して似た画像を作る、の4つです。4問とも正解でした。
AIは解説で、RNN(LSTM)を「識別・予測系」に分けていました。そのうえで、CNNやLSTMも生成に使えることと、GANは識別器を持っていても全体では生成系であることを補足してくれました。
この結果は、AIが想定した典型例に対する正答です。用途だけでモデルが一つに決まるわけではありません。顔写真の生成にVAEを使うこともできます。
復習では、用途に加えて「どんな計算や学習をするか」を確認します。画像の一部を同じフィルターで見るならCNN、前の状態を順に渡すならRNNです。潜在ベクトルを確率的に扱うならVAE、生成器と識別器を競わせるならGAN、と整理します。
確認問題で、LSTM・VAE・GANの見分け方を確かめます
以下は、この記事の復習用に作った問題です。
Q1. 文章のように順番のあるデータを読み、長い文でも前の情報を残しやすくしたモデルはどれですか。
- A. CNN
- B. LSTM
- C. GAN
- D. VAE
答えはBです。RNNの弱点である勾配消失と、それを補うモデルの関係を問う問題です。LSTMはRNNの一種で、ゲートを使って前の情報を長く残します。Aは、画像の近くの並びを読むモデルです。CとDは、新しいデータを作る生成系のモデルです。
Q2. VAEの説明として正しいものはどれですか。
- A. 潜在ベクトルの分布を学び、そこから取り出した値をデコーダに通して、新しいデータを作ります。
- B. 生成器と識別器を競わせて、新しいデータを作ります。
- C. 小さなフィルターを画像にずらして当て、特徴を拾います。
- D. ノイズを何段階もかけて取り除き、画像を作ります。
答えはAです。VAEでは、画像の再現と潜在ベクトルの分布の両方を学びます。BはGAN、CはCNN、Dは拡散モデルの説明です。
Q3. GANについて正しいものはどれですか。
- A. 識別器を含むので、GANは識別系AIに分類されます。
- B. 識別器の判定を手がかりに、生成器が本物らしいデータを作れるようになります。
- C. 入力を潜在ベクトルに圧縮し、元の形に戻すように学びます。
- D. 生成器と識別器は、別々に学習を終えてから組み合わせます。
答えはBです。識別器を通じて得た勾配が、生成器の学習の手がかりになります。Aは、部品の名前とAIの分類を取り違えています。Cはオートエンコーダの基本的な説明です。Dは、生成器と識別器を交互に学ぶ点と食い違います。
まとめ
CNNは小さなフィルターを共通に使い、RNNは前の情報を次へ渡します。VAEは潜在ベクトルを確率的に扱い、GANは生成器と識別器を競わせます。モデル名と代表的な計算を、組にして押さえます。
LSTMはRNNの一種で、情報を長く保持しやすくする工夫があります。Transformerは別の設計ですが、文章の生成まで常に一括で行うわけではありません。
第3回では、Transformerの仕組みと拡散モデルを扱います。生成AIパスポートの連載の順番は、生成AIパスポートの勉強方法にあります。
出典・参考資料(補足資料は2026年10月19日確認):
- 対象範囲は、生成AIパスポート試験シラバスを確認しました。
- LSTMは、Hochreiter・Schmidhuberの論文(英語)を参照しました。
- Attentionは、Bahdanauほかの論文(英語)を参照しました。
- Transformerは、Vaswaniほかの論文(英語)を参照しました。
- VAEとGANは、Kingma・Wellingの論文(英語)とGoodfellowほかの論文(英語)を参照しました。
- CNNと畳み込み、RNNと勾配消失・勾配爆発は、Goodfellowほか『Deep Learning』第9章(英語)と第10章(英語)を参照しました。
- 2012年の競技会の手法は、Krizhevskyほかの論文(英語)を確認しました。
- VAEとGANの傾向は、GoodfellowのGANチュートリアル(英語)とGoogleのGAN解説(英語)を参照しました。
- 潜在拡散モデルは、Rombachほかの論文(英語)を参照しました。
- 今回の補足は、Stanford CS231nのCNN解説、PascanuほかのRNN学習の論文、KerasのVAE実装例、LSTMによる文章生成例も参照しました。

コメント