AIの歴史は、「どうやって問題を解くのか」に注目すると理解しやすくなります。各ブームの中心技術を、探索・推論、専門家の知識、データからの学習という順に整理します。
私はG検定とE資格を持っていて、2027年2月に生成AIパスポートを受験する予定です。この連載は、私自身の受験勉強も兼ねています。
4つの学習方法は、迷惑メールや売上予測を例に整理します。
今回は第1章の基本と歴史を扱います
2027年2月試験からの公式シラバスに沿い、第1章「AIの基礎と歴史」の仕組み・機械学習・歴史を扱います。
AIの基本|ルールベースと機械学習を比べます
AI(人工知能)は、認識・予測・推論などをコンピューターで実現する技術の総称です。
ルールベースと機械学習を、迷惑メールで比べます
ルールベースでは、人が判断の規則を決めます。たとえば「件名に『当選』があれば迷惑メールとする」という規則です。この規則だけでは、「当たりました」と書かれたメールを見逃します。対応するには、規則を追加する必要があります。
機械学習では、データから判断のパターンを学びます。教師あり学習で迷惑メールを判定するなら、メール本文と「迷惑/通常」という正解を組にして与えます。学習後は、初めて見るメールを判定します。
見分けるポイントは、人が判定の規則を書くのか、データから判定のパターンを学ばせるのかです。
ディープラーニングは機械学習に含まれます
ディープラーニング(深層学習)は、ニューラルネットワークの層を重ねて学習する方法です。ニューラルネットワークは、脳の神経のつながりに着想を得た計算の仕組みです。
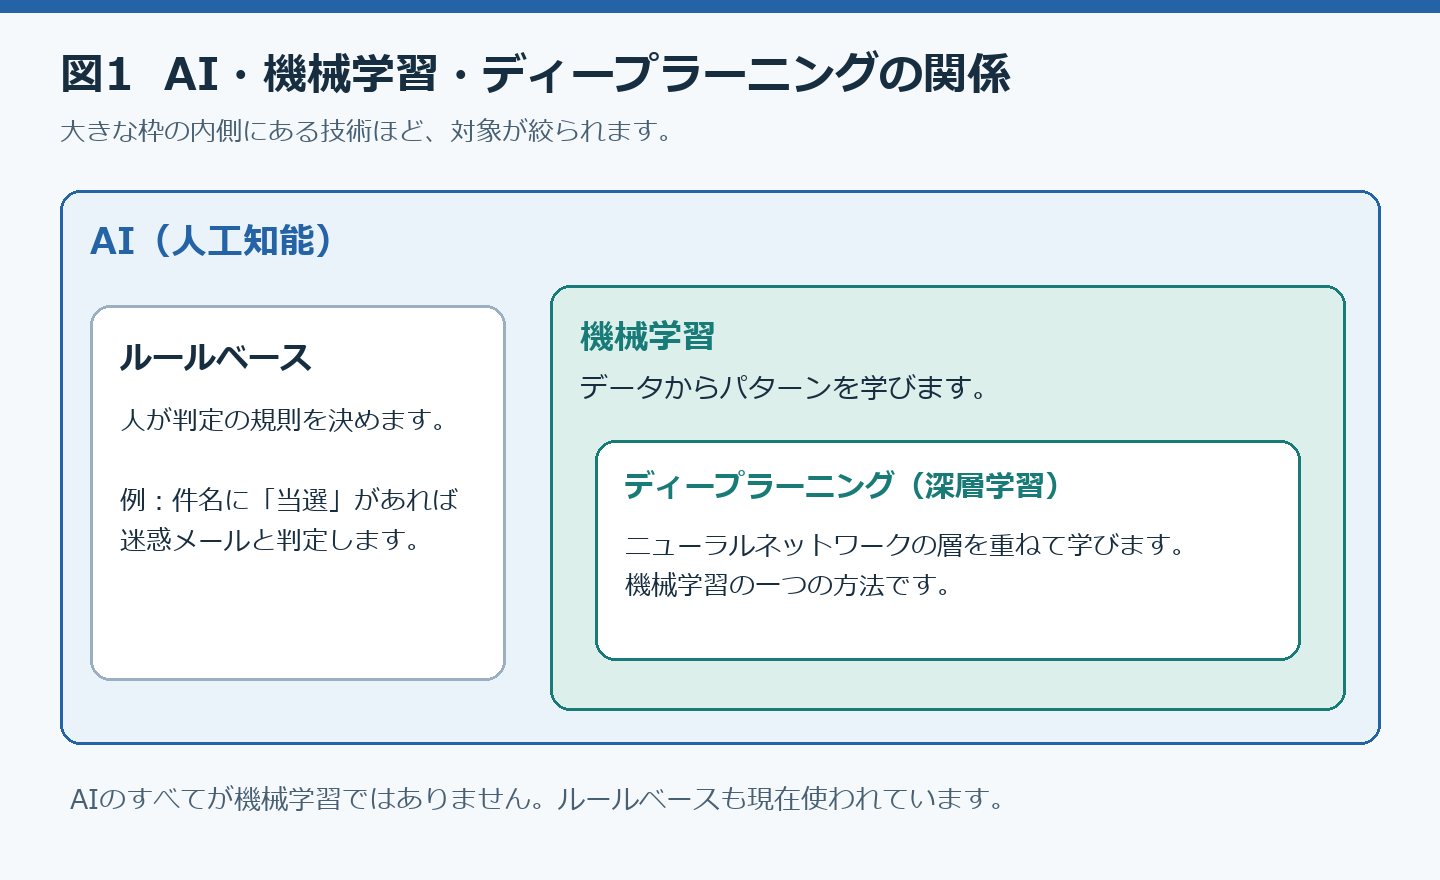
AI・機械学習・ディープラーニングは、同じ意味ではありません。条件が明確な処理では、現在もルールベースが使われます。
AIの歴史|3つのブームの中心技術を押さえます
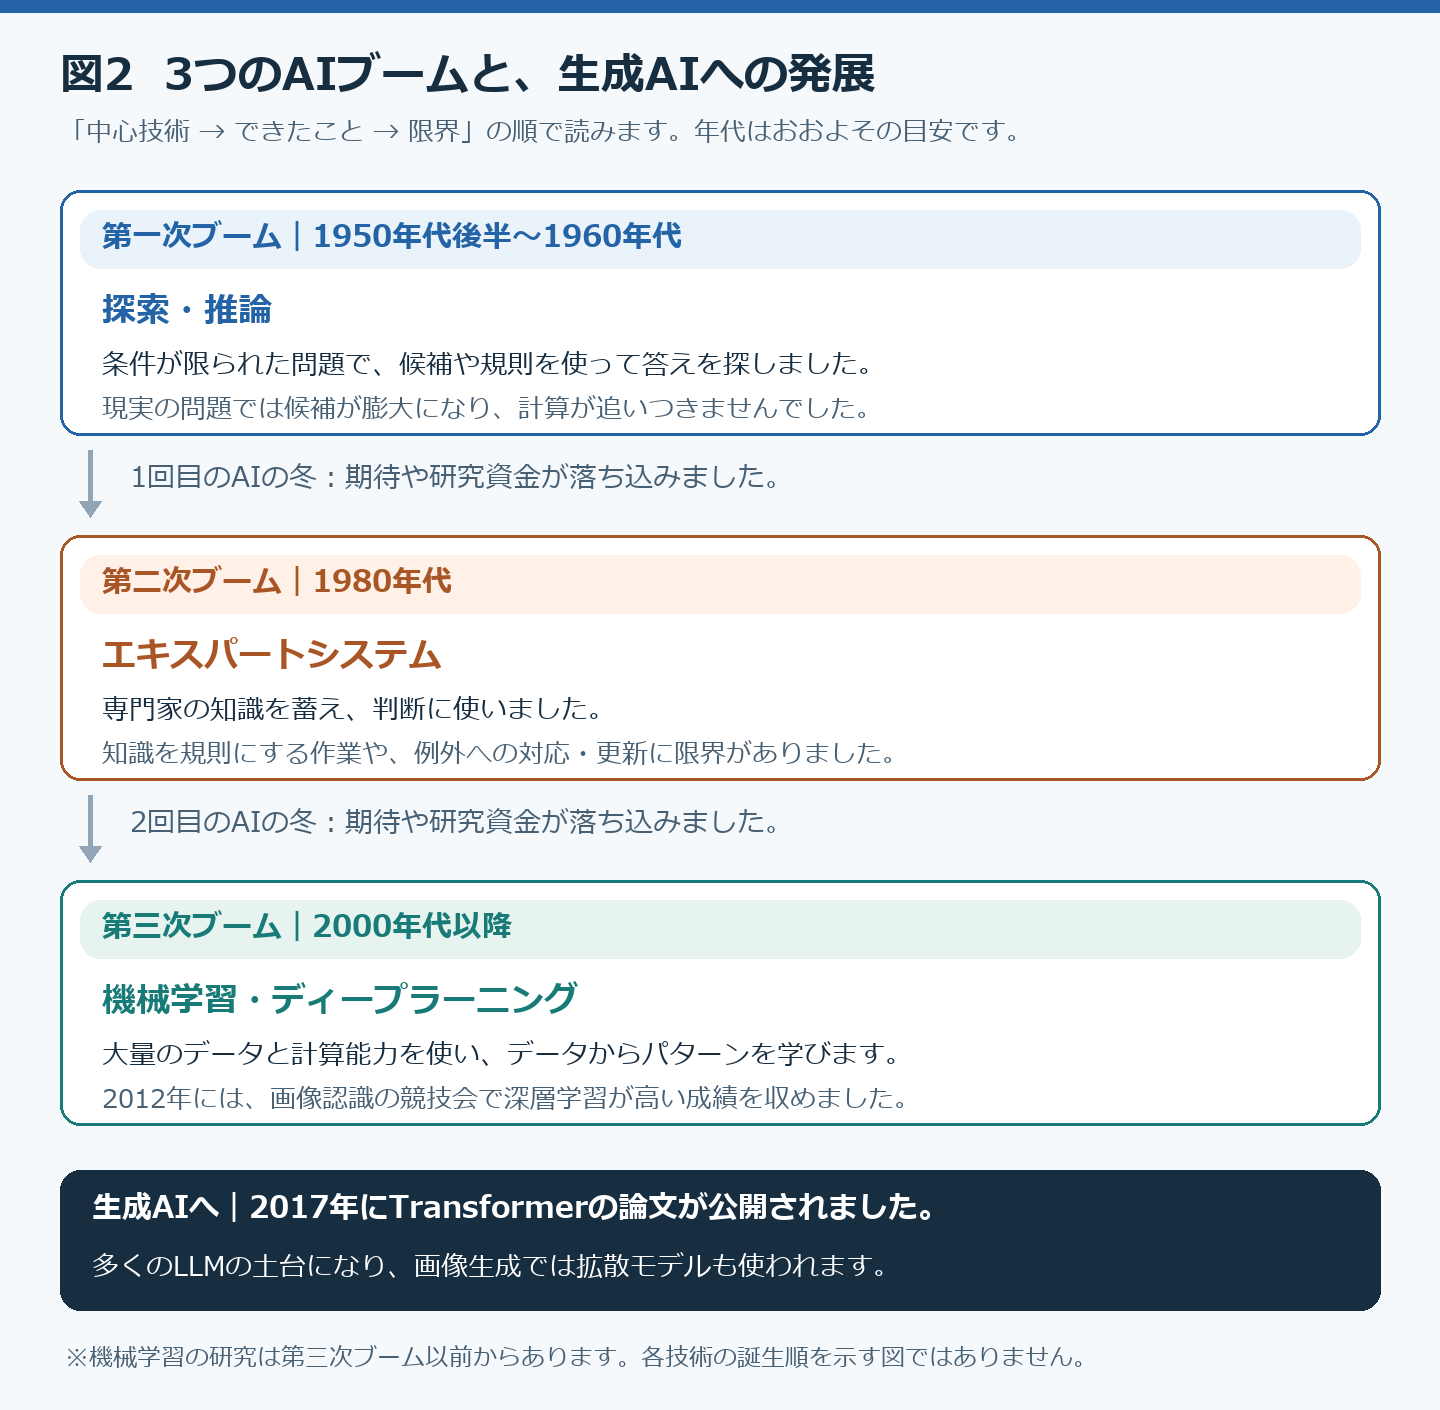
3つのブームの間には、期待した成果が得られず、研究資金や関心が落ち込んだ「AIの冬」がありました。研究そのものが止まったわけではありません。
第一次ブームでは、探索と推論が注目されました
1956年のダートマス会議は、AIが研究分野として出発した節目とされています。1950年代後半〜1960年代には、探索と推論が中心でした。
探索は、迷路の経路探しのように、候補を調べて答えを探すことです。推論は、知識や規則を使って結論を導くことです。
パズルなどでは成果が出ました。しかし、現実の問題では候補が膨大になり、計算が追いつきませんでした。こうした限界から、最初の冬を迎えました。
第二次ブームでは、専門家の知識を使いました
1980年代には、専門家の知識を取り込むエキスパートシステムが注目されました。「この条件なら、この結論」という知識を蓄え、判断に使います。蓄えた知識の集まりを知識ベースと呼びます。
たとえば、機械の故障診断なら、異音や温度から原因を絞る仕組みです。ただし、知識を規則にするには手間がかかります。例外への対応や更新も難しく、再び期待がしぼみました。
第三次ブームでは、データから学ぶ技術が広まりました
2000年代以降は、ビッグデータと呼ばれる大量のデータを利用しやすくなりました。計算能力も向上し、機械学習の活用が広がりました。
機械学習の研究は、それ以前からあります。
2012年には、画像認識の競技会でディープラーニングを使った手法が高い成績を収めました。
生成AIでは、文章や画像を作る技術へ発展しました
2017年には、Transformerを提案する論文が公開されました。文章中のどの部分に注目するかを計算し、言葉どうしの関係を捉える仕組みです。現在の多くのLLM(大規模言語モデル)の土台になっています。
LLMは、大量の文章などから言葉のつながりを学んだモデルです。文章の生成や要約に使われます。画像生成では、ノイズを取り除く過程を学ぶ拡散モデルも使われます。生成時は、ノイズから段階的に画像を作ります。
シンギュラリティ(技術的特異点)は、AIが人間の知能を超え、社会の変化を予測しにくくなるとされる概念です。実現や時期が確定した出来事ではありません。
4つの学習方法|正解ラベルと報酬で比べます
「正解ラベル」は、データに付けた答えです。メールなら「迷惑/通常」が当たります。
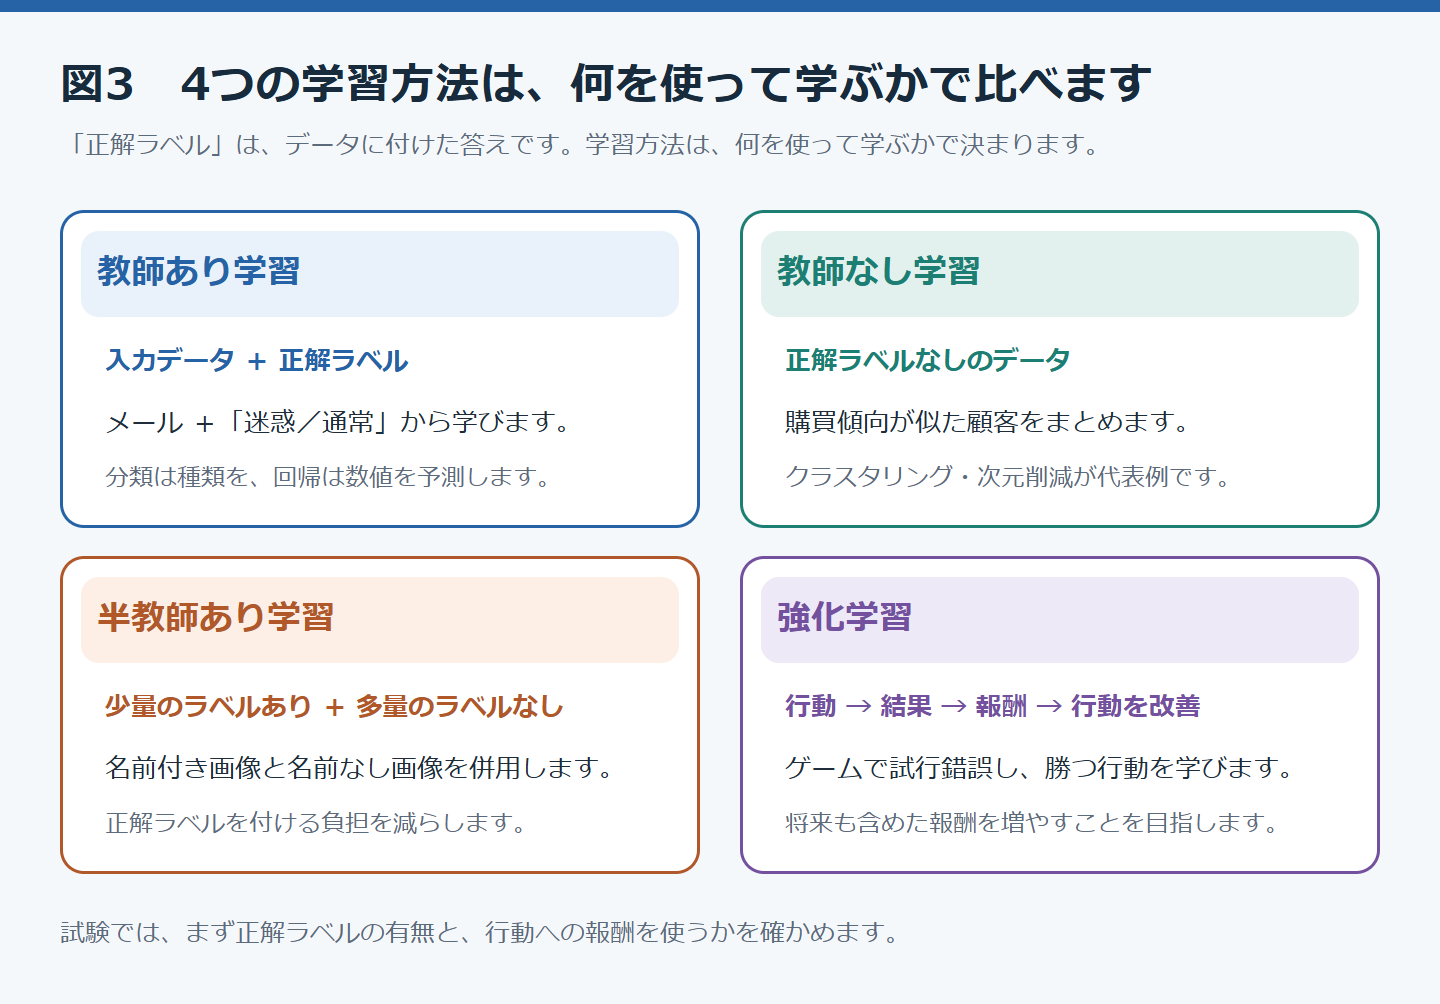
教師あり学習は正解ラベルを使い、教師なし学習は使いません。半教師あり学習は、少量のラベルありデータと多量のラベルなしデータを組み合わせます。正解を付ける手間を減らしたい場合に使います。
分類は種類を、回帰は数値を予測します
教師あり学習の分類では、「迷惑/通常」などの種類を予測します。2種類なら二値分類、3種類以上なら多値分類です。回帰では、来月の売上などの数値を予測します。
分類の正解率は、予測した全件のうち正解した割合です。100件中90件が正解なら90%です。回帰では、予測値と実際の値のずれを評価します。
教師なし学習のクラスタリングは、似たデータをまとめる方法です。正解のグループ名を先に教える分類とは異なります。次元削減は、データの特徴をできるだけ保ち、多くの項目を少ない項目で表す方法です。
強化学習では、先の報酬も考えて行動を学びます
強化学習は、試行錯誤と報酬で学ぶ方法です。報酬は行動の結果に与える点数です。価値は将来の報酬の見込み、方策は状況に応じた行動の選び方です。目先だけでなく、その後も含めた報酬を増やすように学びます。
学習と推論を区別します
データからパターンを身につける段階が学習です。その結果を学習済みモデルと呼びます。新しいデータを入れ、判定や予測を得る段階は推論です。
ノーフリーランチ定理の要点は、あらゆる問題で常に最良となる学習手法はない、ということです。すべての問題を同等に扱うなどの前提があります。実際の仕事では、対象のデータや目的に合わせて手法を選びます。
チャットAIで学習方法を見分けます
次の文を、使っているチャットAIに送ってみてください。
機械学習の教師あり学習・教師なし学習・強化学習の例を1つずつ、どれがどれか伏せて、順番を混ぜて出してください。私が答えたあとで正解を教えてください。私がClaudeで試したときは、犬と猫の写真の判定・客のグループ分け・ロボット掃除機の動き方の3つが出て、3問とも正解でした。
ロボット掃除機だから強化学習、とは限りません。「掃除できたら加点、ぶつかったら減点」のような報酬で、動き方を試して学ぶ場合が強化学習です。
確認問題で理解を確かめます
Q1. 機械学習に当たる迷惑メールの判定方法はどれですか。
- A. 「当選」を含むメールを迷惑とする規則を人が書きます。
- B. メールと正解ラベルの組から、判定のパターンを学ばせます。
- C. 迷惑な送信者のリストを人が登録します。
- D. 件名の長さの基準を人が決めます。
答えはBです。A・C・Dは、人が判定の規則や条件を決めています。
Q2. 正解ラベルなしの購買データから、似た顧客をまとめる方法はどれですか。
- A. 教師あり学習の回帰
- B. 教師なし学習のクラスタリング
- C. 強化学習
- D. 教師あり学習の二値分類
答えはBです。正解のグループを教えず、データの似ている点からまとめます。
Q3. 3つのブームの中心技術を、古い順に並べたものはどれですか。
- A. 探索・推論→エキスパートシステム→機械学習
- B. エキスパートシステム→探索・推論→機械学習
- C. 機械学習→探索・推論→エキスパートシステム
- D. 探索・推論→機械学習→エキスパートシステム
答えはAです。各技術の誕生順ではなく、ブームの中心になった順序を問う問題です。
関連記事:G検定は意味ない?資格は役に立った
まとめ
AIの歴史では、各ブームで何ができるようになり、どこで行き詰まったかを押さえます。学習方法は、正解ラベルや報酬の使い方で比べます。
確認問題で迷ったら、図と具体例を見直してください。次回はニューラルネットワークを扱います。連載の順番は、生成AIパスポートの勉強方法にあります。
出典(2026年10月17日確認):Dartmouth公式/Transformer原論文

コメント