Transformer・拡散モデル・基盤モデルは、横に並ぶ3つの技術ではありません。Transformerはどんな計算をするか、拡散モデルはどんな順で画像を作るか、基盤モデルはどう使われるかに注目すると、3つの関係が見えてきます。
私はG検定とE資格を持っていて、2027年2月に生成AIパスポートを受験する予定です。この連載は、私自身の受験勉強も兼ねています。
今の多くのLLM(大規模言語モデル)は、Transformerを土台にした基盤モデルです。前回(第2回後編)で出てきたエンコーダ・デコーダやノイズと、どこが違うのかも確かめながら、読み進めてみてください。
今回は第2章の技術革新(Transformer以降)を扱います
2027年2月試験からの公式シラバスの第2章には、中項目「生成AIを支える技術革新(Transformer以降)」があります。この中項目の学習項目4つが、すべて今回の対象です。
- Transformer:文中の語どうしの関係を、Self-Attentionで計算します。
- 派生モデル:エンコーダとデコーダのどちらを使うか(両方か)で、BERT・GPT・T5などに分かれます。
- 拡散モデル:ノイズから画像を作ります。各段階で足されたノイズを当てるように学びます。
- 基盤モデル:広いデータで先に学び、多くの用途に合わせるモデルです。
前回「第3回で扱う」とした、Transformerの仕組み・Self-Attention・潜在拡散モデルも、ここで説明します。LLMの学び方と文章の出し方は第4回、ChatGPTなどのサービスは第5回で扱います。
TransformerはSelf-Attentionで、語どうしの関係を計算します
自然言語処理は、人の言葉をコンピュータで扱う分野です。Transformerは、2017年の論文で、翻訳の課題を対象に提案されました。
図1 Self-Attentionは、関連度の割合で各語の情報を混ぜます
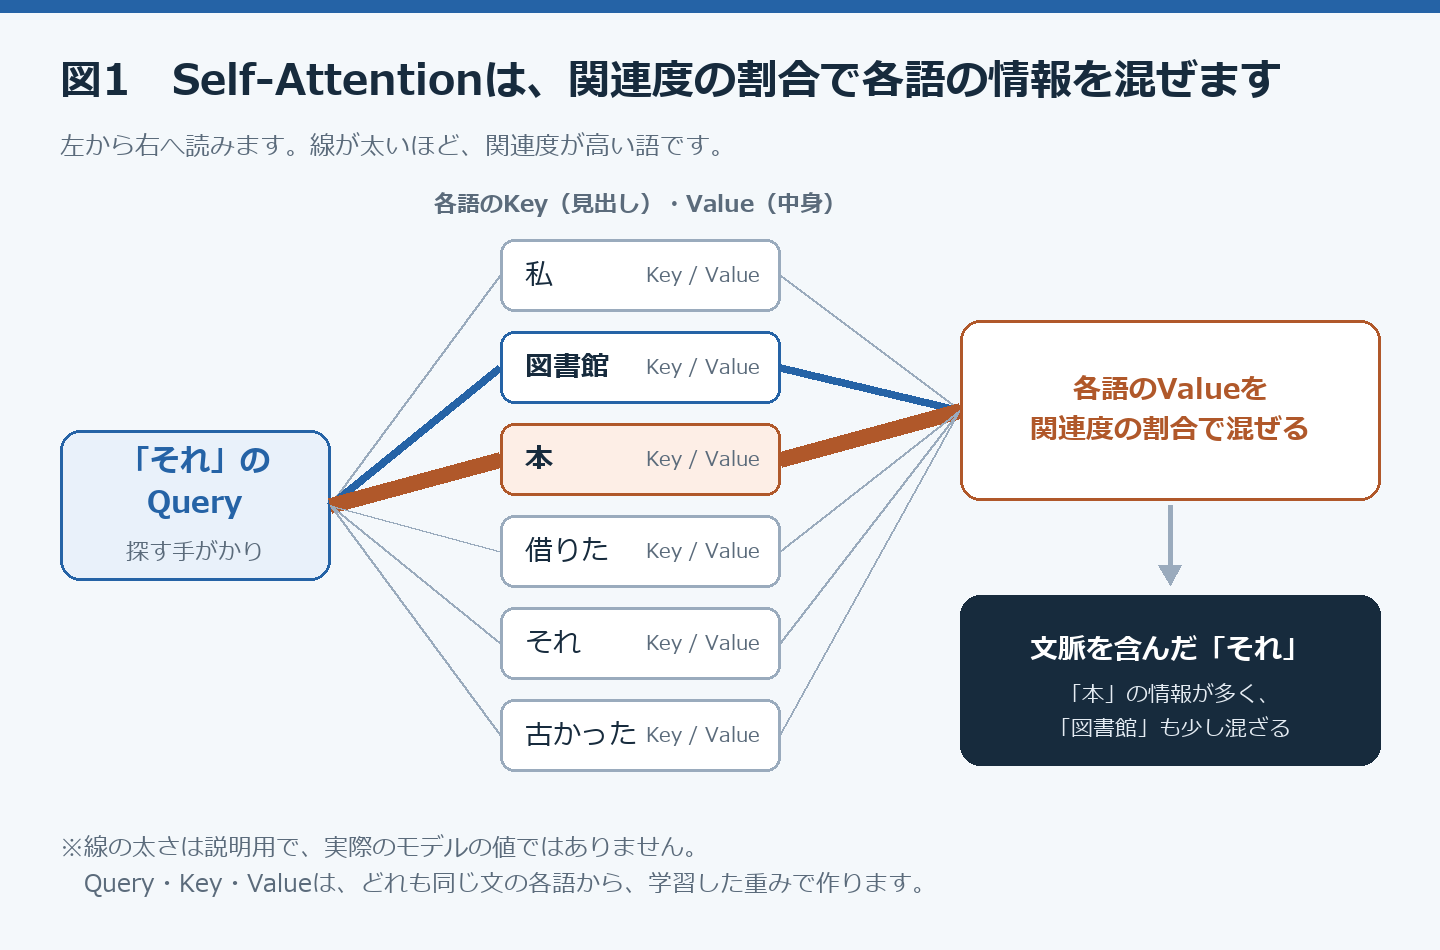
左から右へ読みます。
Self-Attentionは、同じ文の全部の語と関連度を比べます
例文は「私は図書館で本を借りた。それは古かった。」です。人が読めば、「それ」は「本」を指すと分かります。
Self-Attention(自己注意機構)は、「それ」を表す数値の組を、文中の語の情報を集めて作り直します。図1の例では、「本」の情報が多く集まり、「図書館」の情報も少し混ざります。
前回(第2回後編)の翻訳の例では、訳文の語が原文のどこを参照するかを計算しました。これがAttentionです。Self-Attentionでは、参照する相手も同じ文の語です。
全部の語を比べる計算そのものは、語の順番を区別しません。そのため、語の位置を表す情報を足してから計算します。文が長くなると比べる組が増え、計算が重くなります。
Queryは探す手がかり、Keyは見出し、Valueは集める中身です
Query・Key・Valueは、どれも同じ文の各語から作ります。各語を表す数値の組から、学習した重みを使って3つの数値の組を計算します。重みの意味は、生成AIパスポートのニューラルネットワーク(重みと学習)で説明しています。
「注目する」という言い方からは、AIが1語を選ぶように読めます。見分けるポイントは、1つの語を選ぶのではなく、全部の語の情報を関連度の割合で混ぜることです。
「それ」のQueryと全部の語のKeyを比べて、関連度を出します。その割合で各語のValueを混ぜた結果が、文脈を含んだ「それ」になります。同じ計算を、文中のどの語についても行います。
関連度は、学習した重みを使って計算で出た値です。人が語ごとに決める値ではなく、意味を理解した証拠でもありません。また、Query・Key・Valueは、外部のデータベースを検索する仕組みではありません。
私はE資格の勉強で、Query・Key・Valueの計算を行列の式で追いました。この記事では式を使わず、3つの役割を区別して言えるところまでを扱います。
離れた語も直接つながり、学習は並列で進みます|生成は1語ずつ
RNNは、前の語の情報を1語ずつ順に受け渡します。離れた語の情報は、何度も受け渡すうちに薄れやすくなります。学習でも、勾配が前の語まで届きにくい勾配消失が起きやすくなります。
離れた語どうしの関係を、長距離依存と呼びます。Self-Attentionは離れた語どうしも直接比べるので、例文の「それ」と「本」の間に語がいくつ入っても、受け渡しをくり返さずに済みます。
Self-Attentionの計算は、前の語の結果を待たずに、各位置で進められます。そのため、学習のときにまとめて計算しやすくなります。これが並列処理です。
ただし、文章を出すときは学習のときと違います。多くのLLMは、続きの語を1つずつ順に出します。
BERTはエンコーダ型、GPTはデコーダ型|使う部品で得意が分かれます
元のTransformerは、エンコーダとデコーダの両方を持ちます。派生モデルは、名前を覚えるより、どちらの部品を使うかで見ると区別しやすくなります。
図2 Transformerから、使う部品の違いで型が分かれました
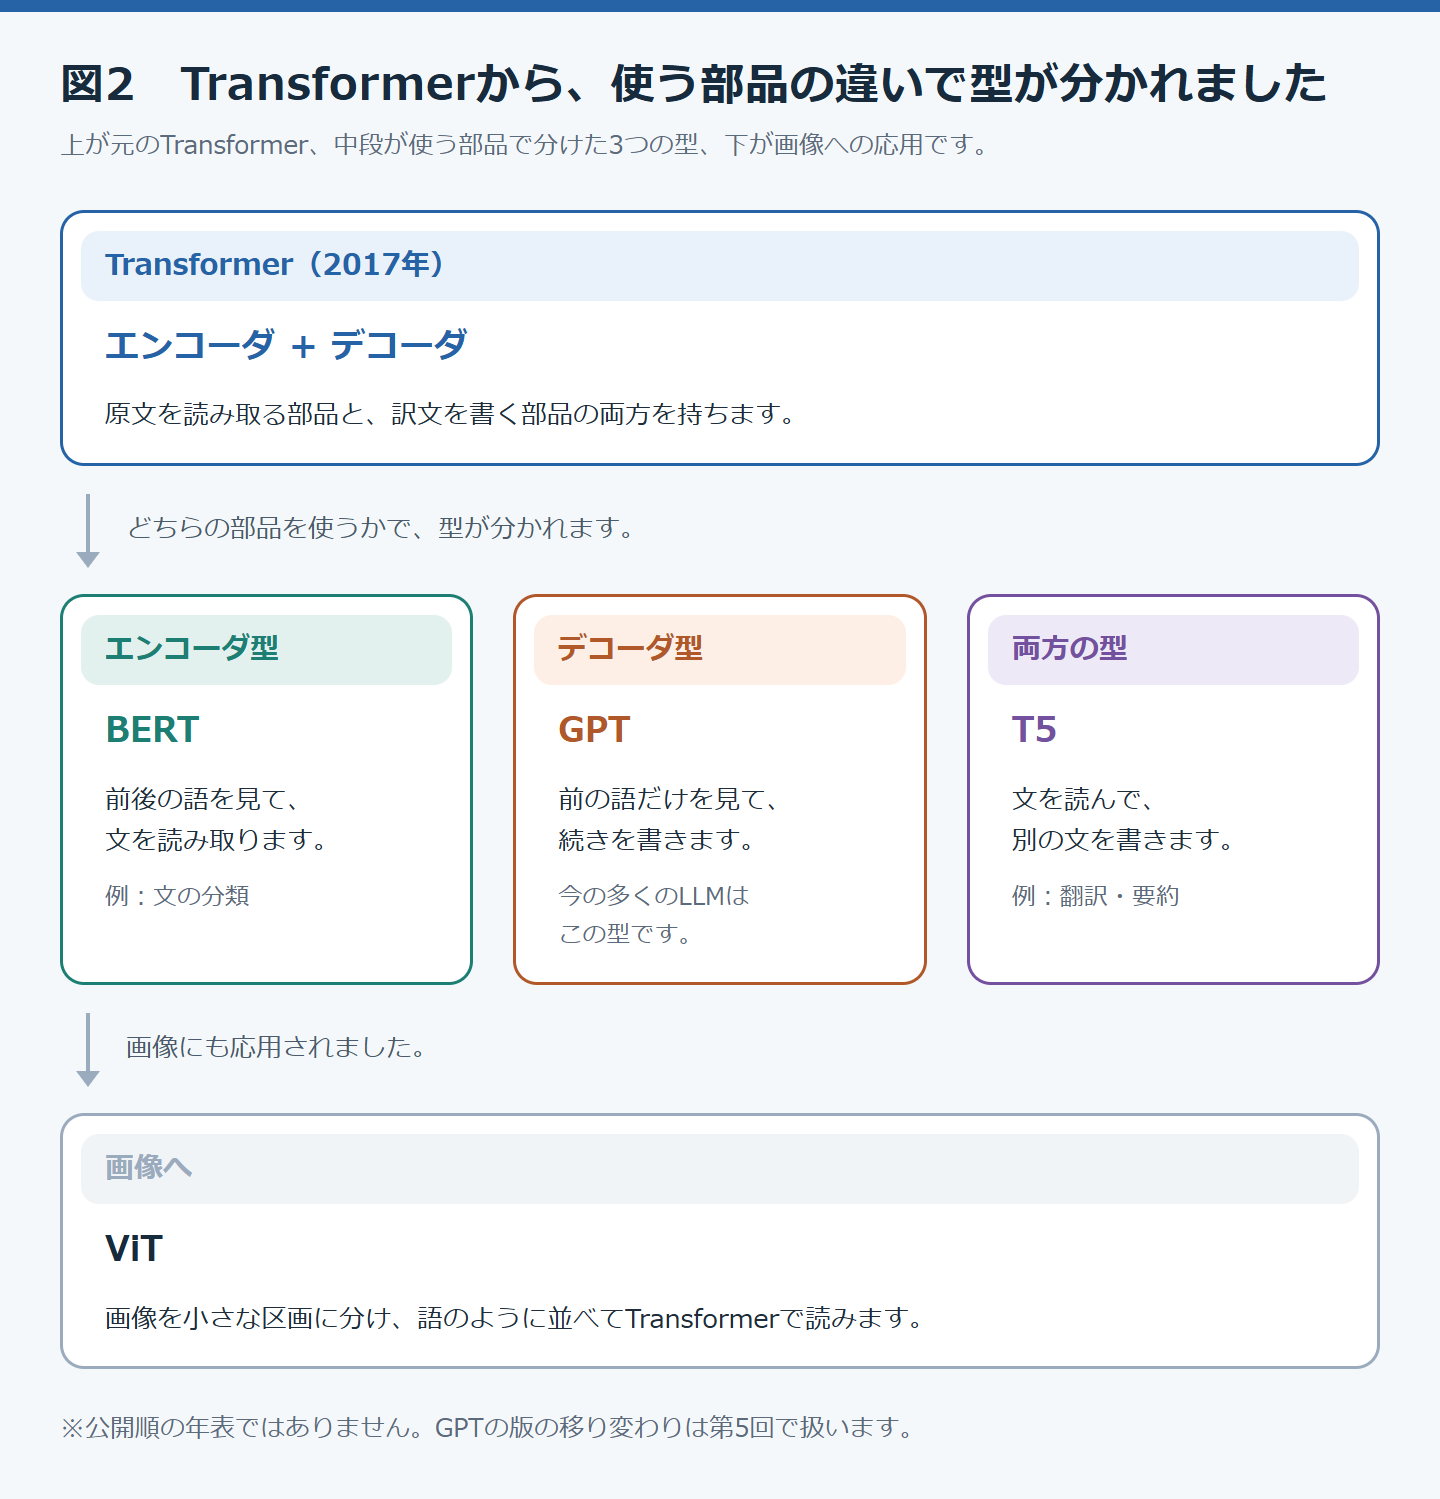
上が元のTransformer、中段が使う部品で分けた3つの型、下が画像への応用です。
エンコーダは入力を読み取り、デコーダは出力を作ります
翻訳なら、原文を読み取って数値の組に表し直すのがエンコーダです。その数値の組を参照しながら、訳文を1語ずつ書くのがデコーダです。
VAEにも、同じ名前の部品が出てきました(第2回後編)。VAEとTransformerのエンコーダ・デコーダは、入力を表し直す側と出力を作る側という、役割の名前が同じなだけです。VAEは確率的な潜在ベクトルを扱い、TransformerはSelf-Attentionで計算します。
BERTは文を読み、GPTは続きを書き、T5は文を別の文に変えます
BERTは、エンコーダの部分を使うモデルです。ある語の前と後ろの両方を見て、文を読み取ります。文を読んで種類を判定する、文の分類のような仕事に向いています。
GPTは、デコーダの部分を使います。前の語だけを見て、続きの語を書きます。今の多くのLLMは、この型です。
T5は、エンコーダとデコーダの両方を使います。翻訳や要約のように、文を読んで別の文を書く仕事に使われます。
ViTは、画像を小さな区画に分け、語のように並べてTransformerで読みます。
BERT・GPT・T5は、新しさで分かれているわけではありません。GPTの版の移り変わりは、第5回で扱います。
拡散モデルは、各段階で足されたノイズを当てるように学びます
拡散モデル(Diffusion Model)の考え方は、Transformerより前の論文からあります。画像生成で注目されたのは、2020年のDDPMという論文の後です。シラバスの「拡散モデルの登場」は、考え方が生まれた年ではなく、画像生成で注目された時期と読みます。
拡散過程は、決まった手順で画像にノイズを足していきます
花の写真(前回と同じ例)に、ランダムなノイズを少しだけ足します。足した画像にさらに足すことを何段階もくり返すと、最後はノイズだけの画像になります。
どの段階でどれだけ足すかは、先に決めた手順に従います。拡散過程は計算の手順なので、モデルが学ぶものではありません。
モデルは、ある段階の画像を見て、その段階で足されたノイズを当てるように学びます。学習用の写真に手順どおりノイズを足し、足したノイズを正解にして練習します。
図3 拡散過程はノイズを足し、逆拡散過程はノイズを引きます
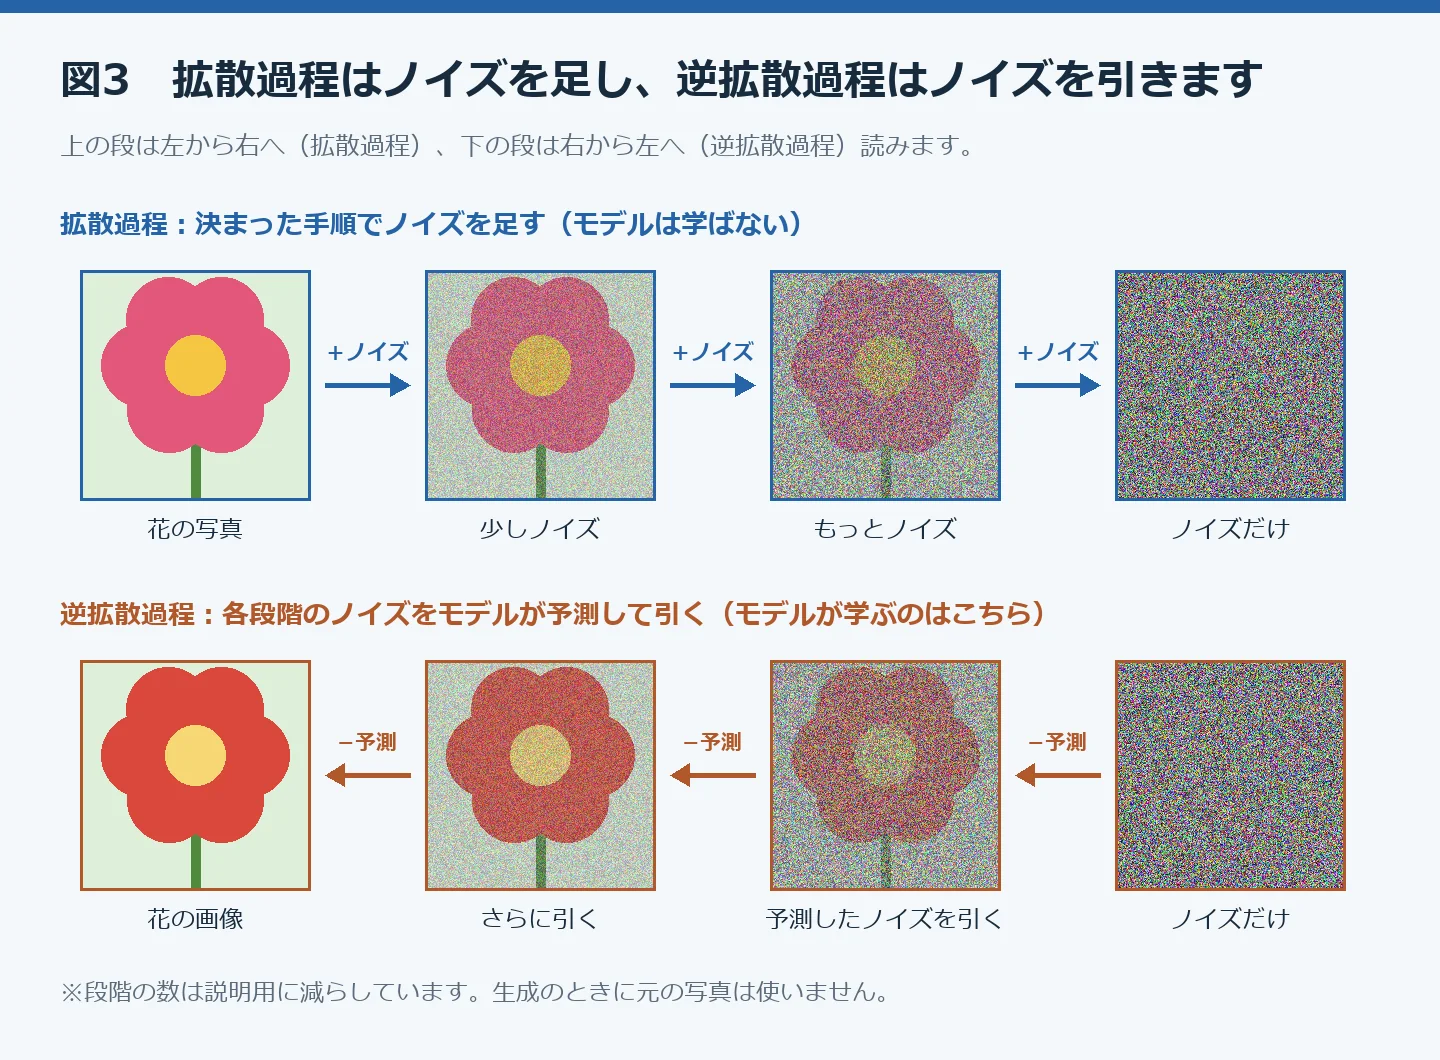
上の段は左から右へ(拡散過程)、下の段は右から左へ(逆拡散過程)読みます。
逆拡散過程では、予測したノイズを1段ずつ引いて画像を作ります
生成のときに、元の写真はありません。ノイズだけの状態から始め、モデルが「この段階で足されているノイズ」を予測して引くことを、何度もくり返します。
生成AIパスポートのVAE・GAN(第2回後編)で見たVAEとGANは、1回の計算で画像を作ります。拡散モデルは少しずつ直すので、段階の数だけ計算をくり返します。
VAEは、潜在ベクトルを取り出すときにランダムさを使いました。拡散モデルでは、段階的に足したノイズを、モデルが当てて引きます。
見分けるポイントは、ノイズを足す向きは手順で決まり、モデルが学ぶのは引く向きだという点です。
潜在拡散モデルは、圧縮した表現の上でノイズを足し引きします
図4 潜在拡散モデルは、学習のときと生成のときで使う部品が違います
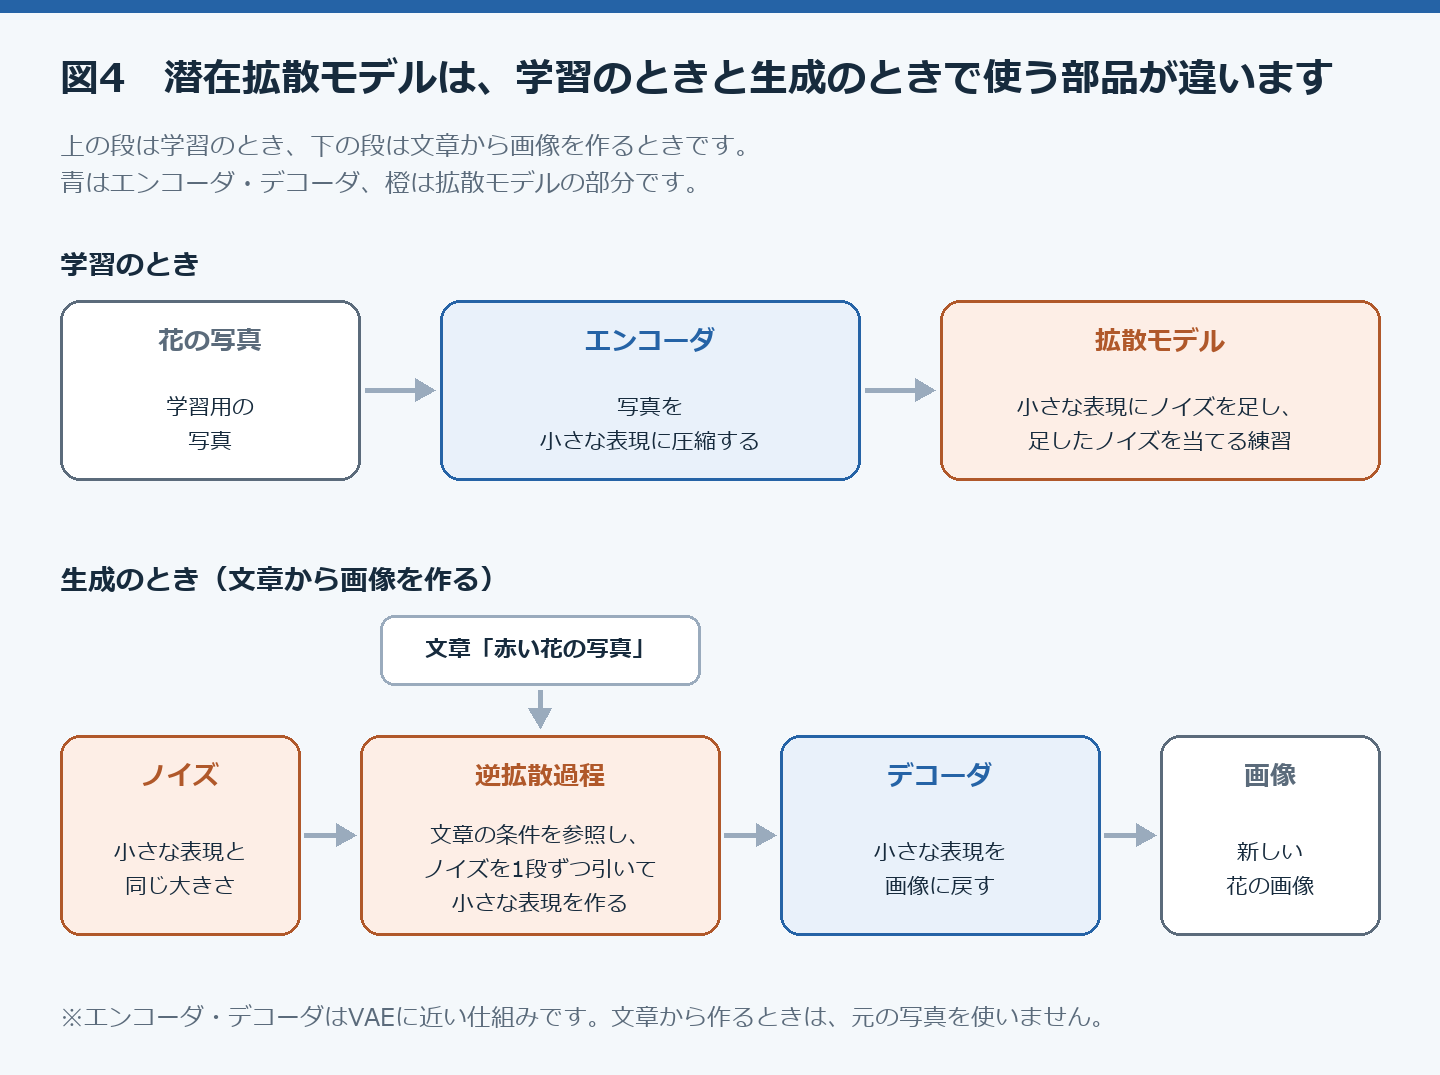
上の段は学習のとき、下の段は文章から画像を作るときです。青はエンコーダ・デコーダ、橙は拡散モデルの部分です。
画素のままノイズを足し引きすると、段階ごとの計算が重くなります。そこで潜在拡散モデル(Latent Diffusion Model)は、先に画像を小さな表現に圧縮します。
「潜在」は、VAEに近い仕組みで小さく圧縮した表現を指します。ノイズの足し引きは拡散モデルが、圧縮と復元はエンコーダ・デコーダが受け持ちます。
ノイズを引く各段階で、モデルはAttentionの仕組みを使って、「赤い花の写真」のような文章の条件を参照します。
文章から画像を作るときは、小さな表現と同じ大きさのノイズから始めます。逆拡散過程で小さな表現を作り、最後にデコーダで画像に戻します。エンコーダは、学習のときに写真を圧縮するために使います。
Stable Diffusionは、潜在拡散モデルをもとにした画像生成AIです。
LLMは基盤モデルの一種|画像や音声を扱う基盤モデルもあります
基盤モデル(Foundation Model)は、TransformerやSelf-Attentionのような計算の名前ではありません。学び方と使われ方に付いた呼び名です。
図5 LLMは基盤モデルの一種で、扱う情報の種類で呼び方が変わります
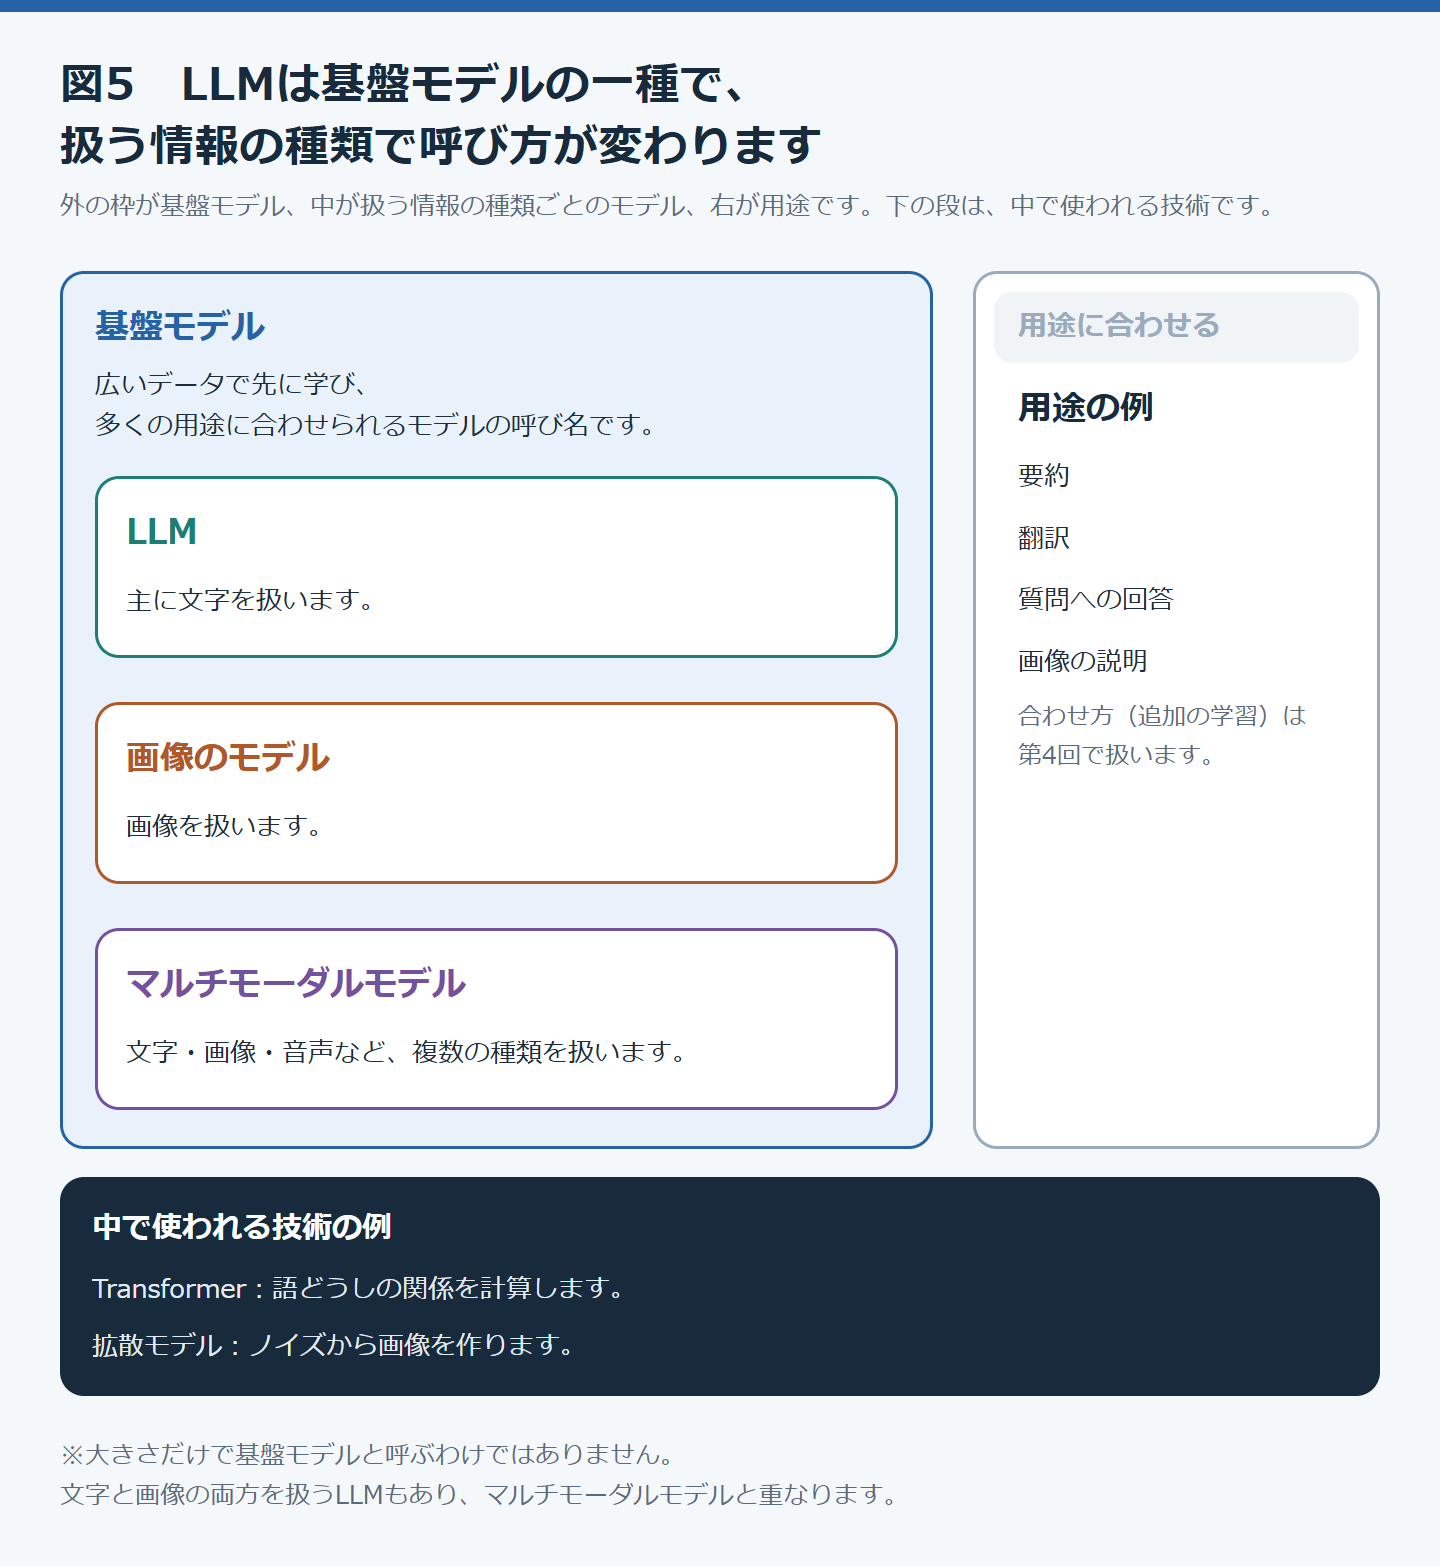
外の枠が基盤モデル、中が扱う情報の種類ごとのモデル、右が用途です。下の段は、中で使われる技術です。
基盤モデルは、広いデータで先に学び、用途に合わせて使うモデルです
この呼び名は、2021年にスタンフォード大学の研究者たちが論文で付けました。論文では、広いデータで大規模に学び、幅広い用途に合わせられるモデルを指します。
たとえば1つのLLMを、要約にも、翻訳にも、質問への回答にも使い分けます。用途に合わせるための追加の学習は、第4回で扱います。
基盤モデルかどうかは大きさだけでは決まらず、多くの用途に合わせて使えることも条件です。
基盤モデルは、そのまま何でもできる完成品でもありません。名付けた論文も、土台であると同時に未完成だという性格を強調しています。
文字を中心に扱う基盤モデルがLLMです。画像や音声を扱う基盤モデルもあるので、基盤モデルはLLMの別名ではありません。
マルチモーダルは、文字・画像・音声など複数のモダリティを扱うことです
モダリティは、情報の種類です。文字・画像・音声・動画などが当たります。マルチモーダルは、複数の種類を入力や出力に使うことです。それができるモデルを、マルチモーダルモデルと呼びます。
マルチモーダルは、画像を作れるという意味ではありません。写真を見せて、写っているものを文章で答えさせるだけでも、画像と文字の2種類を扱っています。
チャットAIに画像を説明させ、マルチモーダルを確かめます
個人情報や仕事の資料が写っていないスクショか写真を1枚選び、画像を貼れるチャットAIに貼ってください。そのうえで、次の文を送ってください。
この画像に何が写っているか、3行で説明してください。私は、いちごのタルトの写真をChatGPTに貼って試しました。返ってきた3行は次のとおりです。
サクサクしたタルト生地の上に、真っ赤ないちごがたっぷり盛られています。
いちごの間にはブルーベリーが飾られ、周囲には生クリームが美しく絞られています。
赤いテーブルの上に置かれた、華やかでおいしそうなフルーツタルトです。
写真と見比べると、かなり正確でした。3行に収めたためか、手前のフォークと右下の松ぼっくりには触れていませんでした。
このやりとりは、画像を入れて文字で答えてもらうので、モダリティをまたいでいます。AIの説明が画像と合っているかは、自分の目で見比べて確かめてください。この確認で分かるのは入力と出力の種類までで、中でどの技術が動いているかは分かりません。
確認問題で、Self-Attention・拡散・基盤モデルを確かめます
以下は、この記事の復習用に作った問題です。
Q1. Self-AttentionのQuery・Key・Valueの説明として正しいものはどれですか。
- A. Queryは外部のデータベースへ送る検索文で、Keyはその検索結果です。
- B. Queryは比べる側の手がかり、Keyは各語の見出し、Valueは集める中身です。3つとも同じ文の各語から作ります。
- C. Valueは語の順番を表し、位置の情報の代わりになります。
- D. Query・Key・Valueは、人が語ごとに決めて入力します。
答えはBです。3つの役割と、どこから作るかを問う問題です。Query・Key・Valueは、どれも同じ文の各語から作ります。Aは、外部の資料を検索する仕組みと混同しています。外部の資料を使うRAGは、第7回で扱います。Cの位置の情報は、Query・Key・Valueとは別に足します。Dは、3つとも学習した重みを使って作る点と食い違います。
Q2. 拡散モデルで画像を生成するときの説明として正しいものはどれですか。
- A. ノイズの足し方をモデルが学び、生成のときもノイズを足していきます。
- B. 生成のたびに元の写真をエンコーダに入れて、描き直します。
- C. ノイズだけの状態から、各段階のノイズをモデルが予測して引くことをくり返します。
- D. 生成器と識別器を競わせ、1回の計算で画像を作ります。
答えはCです。2つの向きと、モデルが学ぶものを問う問題です。生成のときは元の写真が無いので、ノイズだけの状態から始めます。Aは、学ぶ向きを取り違えています。ノイズを足す向きは、決まった手順です。Bは、学習のときの流れと混同しています。DはGANの説明です。
Q3. 基盤モデル・LLM・マルチモーダルの関係として正しいものはどれですか。
- A. LLMは基盤モデルの一種です。文字と画像など複数のモダリティを扱えるモデルは、マルチモーダルモデルと呼びます。
- B. 基盤モデルは、文字だけを扱うLLMの別名です。
- C. マルチモーダルは、画像を生成できるという意味です。
- D. 基盤モデルは、調整しなくてもどの仕事にも使える完成品です。
答えはAです。どちらがどちらに含まれるかと、モダリティの意味を問う問題です。LLMは、文字を中心に扱う基盤モデルです。Bは、画像や音声を扱う基盤モデルを見落としています。Cは、「複数の種類の情報を扱う」ことと「画像を作る」ことを混同しています。Dは、用途に合わせて使う点を見落としています。
関連記事:生成AIパスポートのAIの歴史
まとめ
Transformerは語どうしの関係を計算する仕組み、拡散モデルはノイズから画像を作る手順、基盤モデルは学び方と使われ方に付いた呼び名です。
Query・Key・Valueの役割と、拡散の2つの向きを、それぞれ1文で言えるか確かめてください。第4回は、LLMの学習と生成を扱います。生成AIパスポートの連載の順番は、生成AIパスポートの勉強方法にあります。
出典・参考資料(2026年10月20日確認):
- 対象範囲は、生成AIパスポート試験シラバスを確認しました。
- Transformerは、Vaswaniほかの論文(英語)を参照しました。
- 派生モデルは、BERT・GPT・T5・ViTの各論文(英語)と、ZhaoほかのLLMのサーベイ(英語)を参照しました。
- 拡散モデルは、Sohl-Dicksteinほかの論文(英語)とHoほかのDDPMの論文(英語)を参照しました。
- 潜在拡散モデルとStable Diffusionは、Rombachほかの論文(英語)と公開元のGitHub(英語)を参照しました。
- 基盤モデルは、Bommasaniほかの論文(英語)を参照しました。

コメント