ニューラルネットワークの学習は、「予測する→正解とのずれを測る→重みを調整する」という繰り返しです。まずは、この流れの中で各用語が何を指すかを押さえます。
私はG検定とE資格を持っていて、2027年2月に生成AIパスポートを受験する予定です。この連載は、私自身の受験勉強も兼ねています。
今回は、迷惑メールの判定を例に仕組みを説明します。そのあとで、学習データに合わせすぎる「過学習」と、学んだことを別の課題に生かす「転移学習」を整理します。
今回は第1章「ニューラルネットワーク」の前半を扱います
2027年2月試験からの公式シラバスには、「ニューラルネットワーク」の学習項目が11あります。今回は、次の5項目が対象です。
- 人間の脳とニューラルネットワークの関係を学びます。
- ディープラーニング(深層学習)の意味を押さえます。
- 重みの調整による学習の仕組みを追います。
- 過学習が起きる様子と、その対策を確かめます。
- 転移学習の使い方を整理します。
後半のCNN・RNNなど6項目は、後編にまとめます。この記事では数式を使わず、各計算の役割から説明します。
ニューラルネットワークは、数値を層から層へ渡して予測します
ニューラルネットワークは、脳の神経のつながりに着想を得た計算の仕組みです。脳そのものを再現したものではありません。
入力層・隠れ層・出力層で、データを順に処理します
迷惑メールを判定するなら、メールを数値にして入力します。ここでは説明のため、「当選」という語の有無やリンクの数を使います。
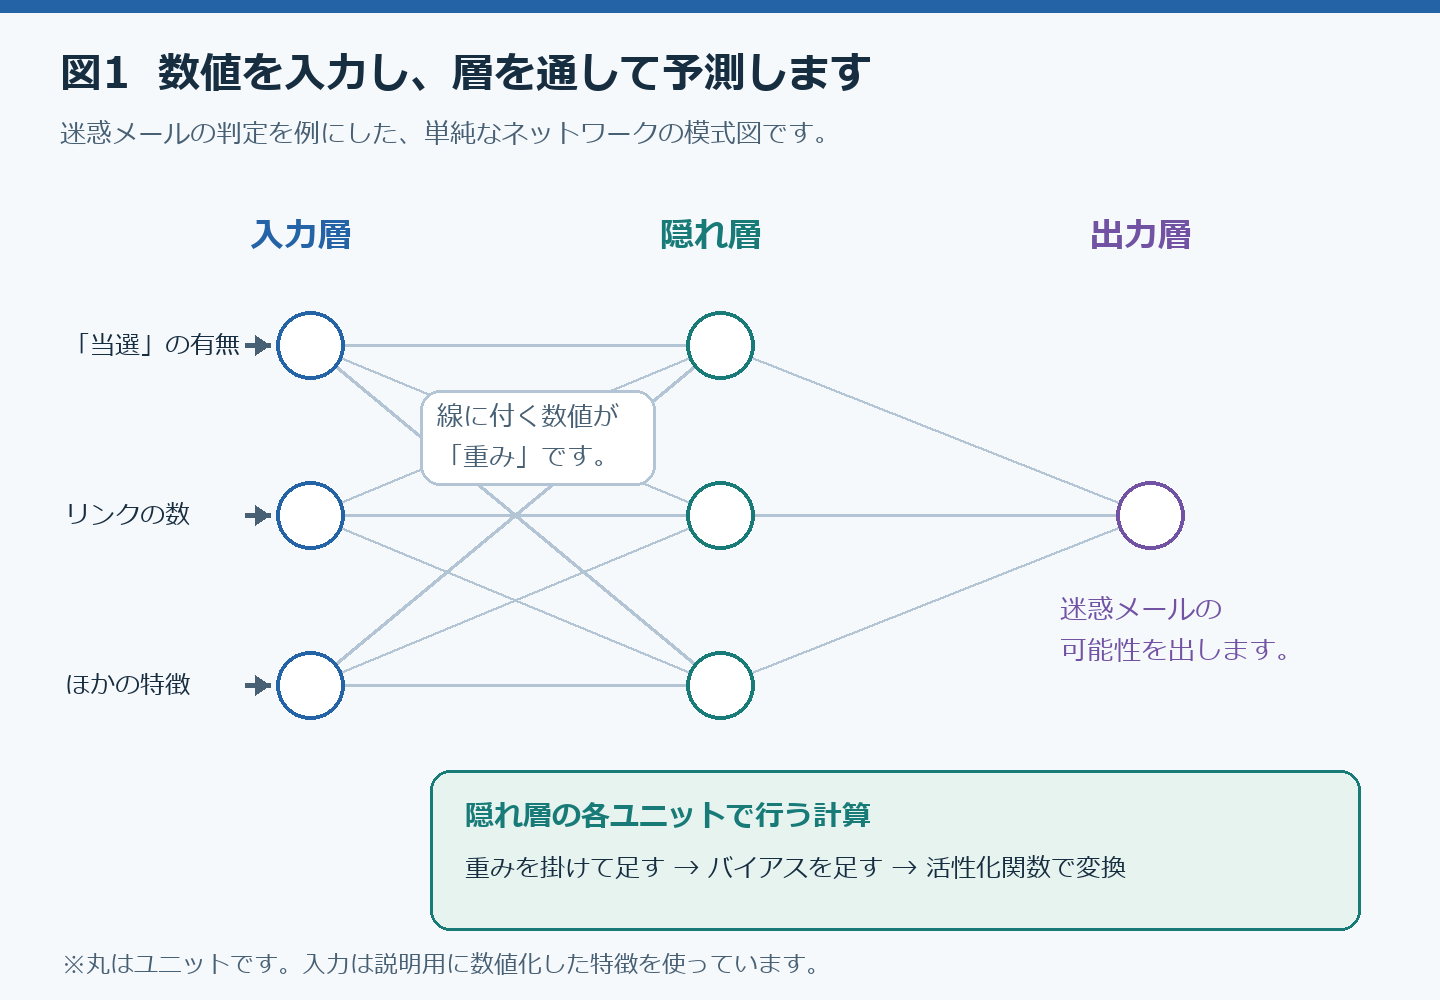
入力層はデータを受け取る入口です。隠れ層は、受け取った値を計算して次へ渡します。出力層は、計算の結果を予測として出します。この例では「迷惑メールの可能性」を出力します。
隠れ層の「隠れ」は、人から見えないという意味ではありません。入力と出力の間で計算を担う層を指します。
重みは、値の伝わり方に影響する数値です
層の中には、値を受け取って計算するユニットがあります。ユニット同士のつながりには、重みという数値が付いています。
基本的なユニットでは、入力に重みを掛けて足し合わせます。さらに、計算の基準を調整するバイアスという値を加えます。学習では、主にこれらの数値を調整します。ここからは、まとめて「重みを調整する」と説明します。
たとえば、「当選」という語の入力に掛かる重みが変わると、次のユニットへ渡る値も変わります。ただし、最終的な判定はほかの重みや層にも左右されます。「重みが大きいほど必ず迷惑と判定する」とは限りません。
活性化関数は、複雑な関係を学べるようにします
活性化関数は、重みを掛けて足した値を変換する関数です。代表例のReLUでは、負の値を0にし、正の値はそのまま渡します。
こうした変換を挟むことで、単純な足し算と掛け算だけでは表せない関係を学べます。これが活性化関数を使う理由です。関数の種類は通常、学習の前に決めます。
ディープラーニングは、このような計算の層を深く重ねて学習する方法です。何層から「深い」と呼ぶかに、統一された基準はありません。
学習では、ずれを測ってから重みを調整します
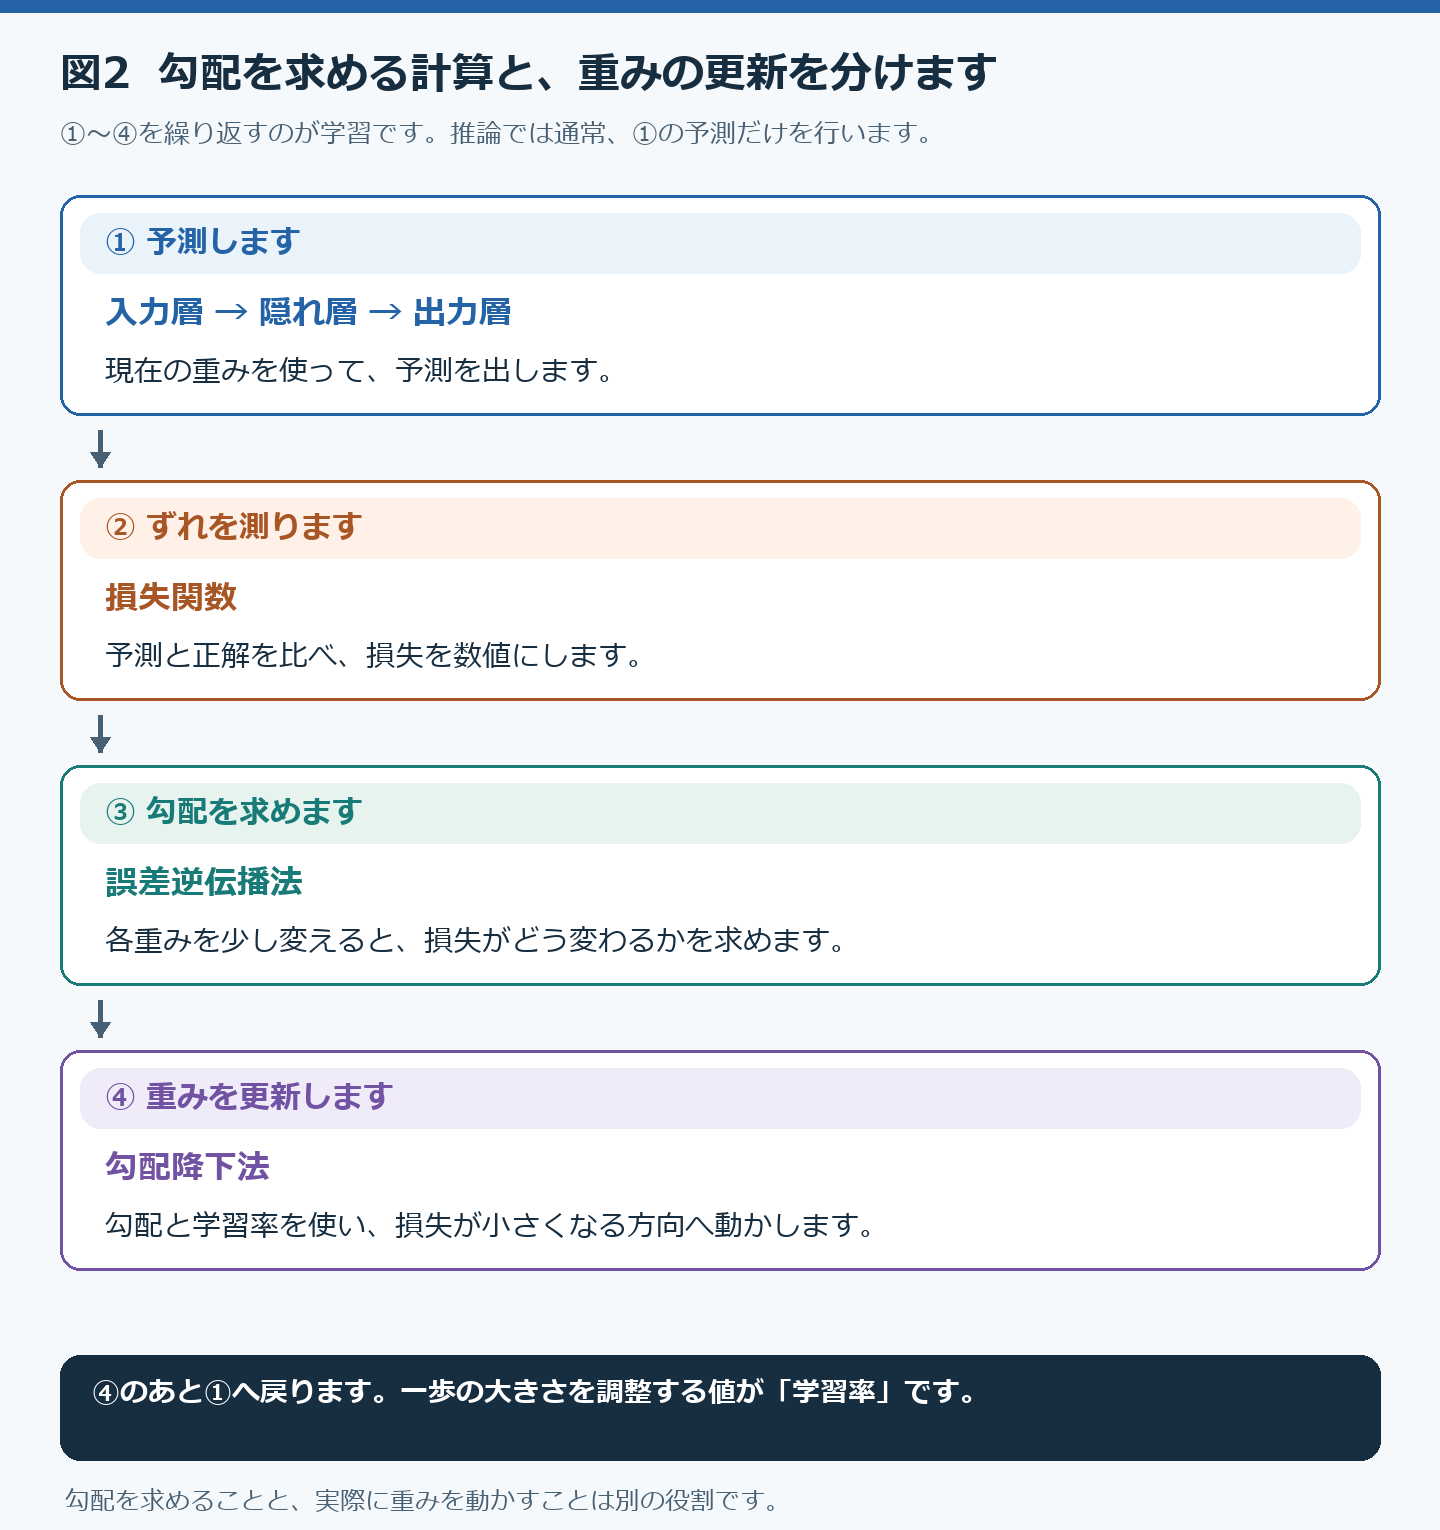
図2は、学習の1回分を示しています。予測に使う計算と、重みを調整するための計算を分けて見てください。
損失関数は、予測と正解のずれを数値にします
正解が「迷惑」のメールに対し、「迷惑の可能性30%」と予測したとします。このような分類で使う代表的な損失関数では、90%と予測した場合より損失が大きくなります。損失が小さいほど、正解に近い予測です。
活性化関数は、ユニットの計算結果を変換します。損失関数は、予測と正解を比べます。名前は似ていますが、役割が違います。
誤差逆伝播法は勾配を求め、勾配降下法は重みを更新します
誤差逆伝播法(バックプロパゲーション)は、出力側から前の層へ計算をさかのぼります。求めるのは、各重みを少し変えたときに、損失がどちらへどれだけ変わるかです。この変化の度合いを勾配と呼びます。
勾配降下法は、その勾配を使い、損失が小さくなる方向へ重みを更新します。一度にどれくらい動かすかを調整する値が、学習率です。
坂道にたとえるなら、誤差逆伝播法は足元の傾きを求める計算です。勾配降下法は、その傾きを使って下る方向へ進む方法です。学習率は一歩の大きさに当たります。
誤差逆伝播法が求めるのは勾配です。実際に重みを更新するのが勾配降下法です。
この流れを繰り返し、学習を終えた状態が学習済みモデルです。新しいメールを判定するときは、通常、学習した重みを使って予測だけを行います。この段階を推論と呼びます。
私はE資格の勉強で、この計算を微分の式で追いました。今回は式を追う前に、損失関数・誤差逆伝播法・勾配降下法の役割を区別することを目標にします。
過学習は、学習データに合わせすぎた状態です
学習を続けて損失が小さくなっても、それだけでは良いモデルとは言えません。初めて見るデータでも予測できるかを確かめます。
汎化を確かめるため、学習用とは別のデータを使います
練習問題の答えだけを覚えると、同じ問題では満点でも、初めての問題では解けないことがあります。過学習(オーバーフィッティング)は、これに似ています。学習データに特有の細かな癖まで合わせ、新しいデータでは予測がうまくいかない状態です。
一方、学習に使っていないデータにも対応できる性質を、汎化と呼びます。その様子を確認するため、重みの更新には使わない検証データを用意します。
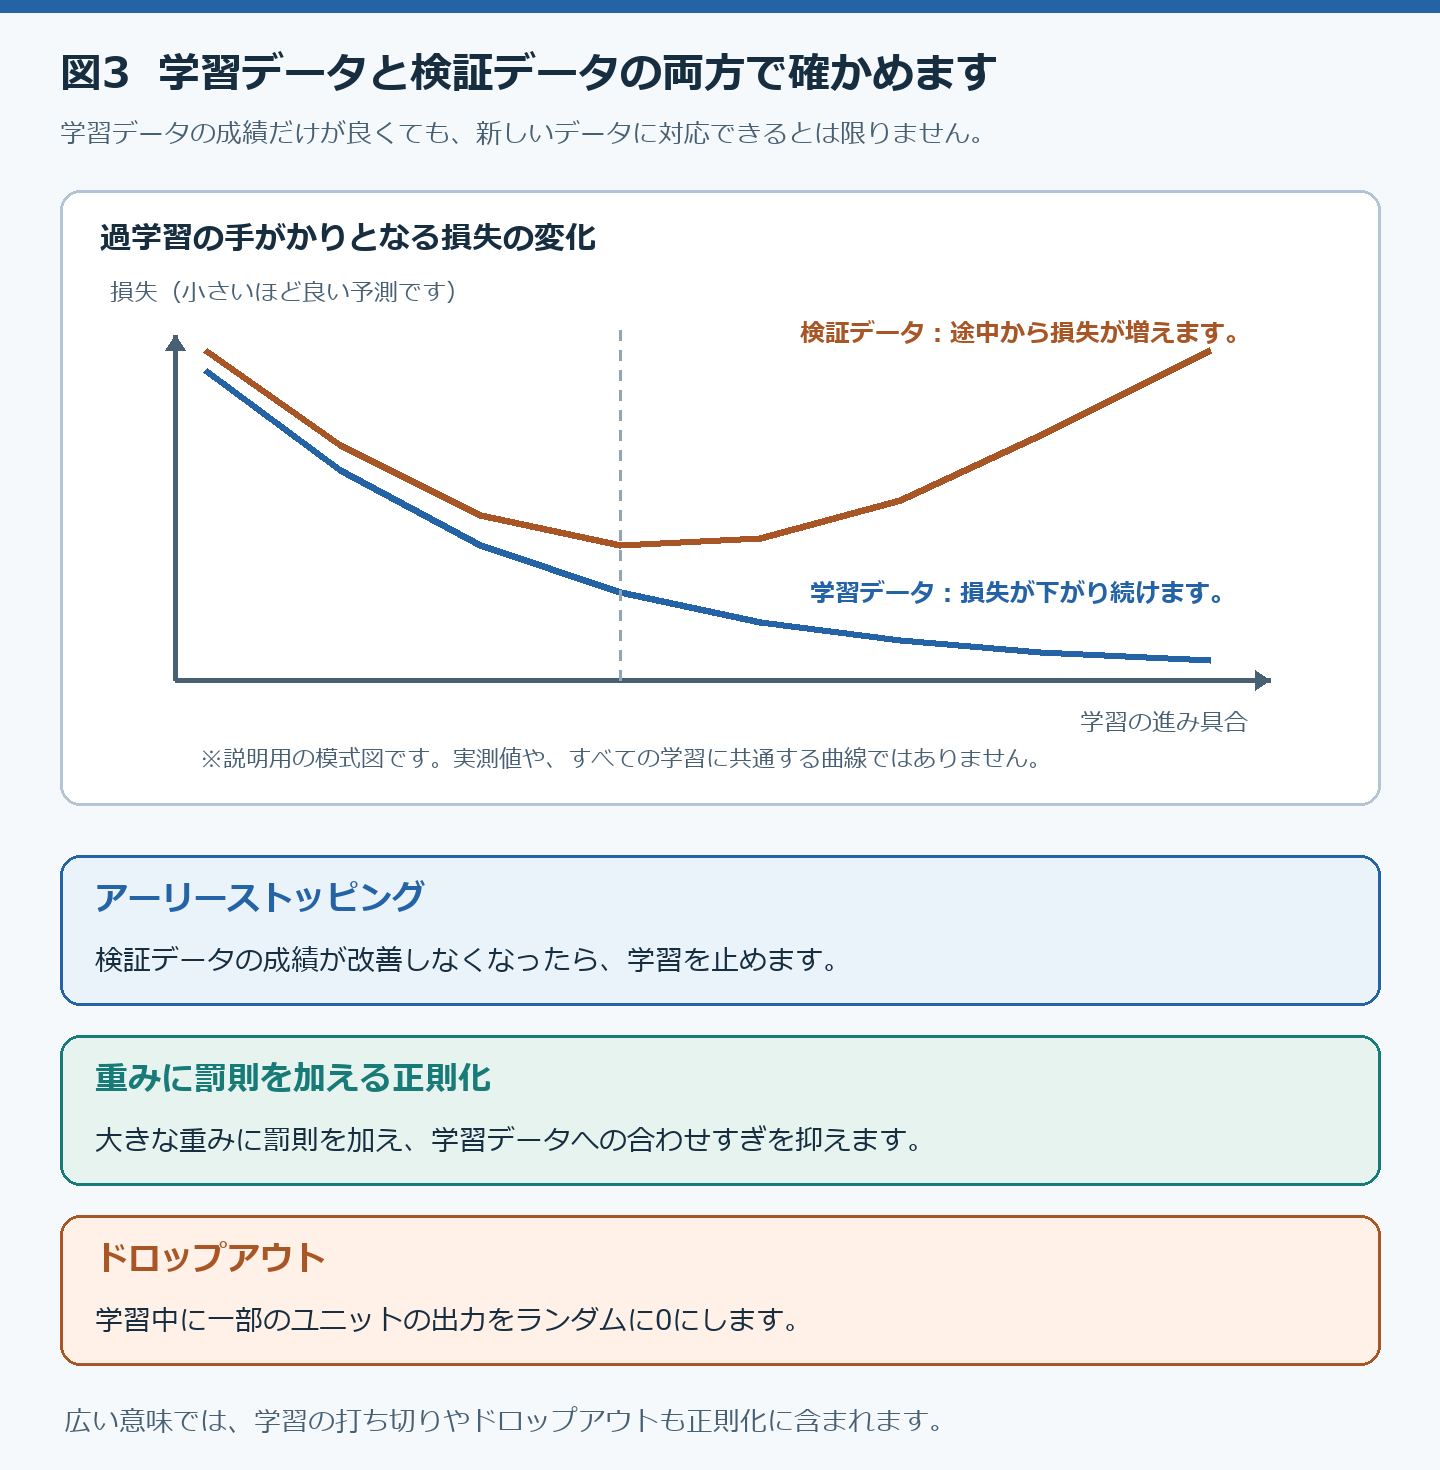
図3の曲線は説明用の模式図です。学習データの損失は下がり続けても、検証データの損失が上がり始める場合があります。これは、過学習を疑う手がかりです。
対策は、学習の止めどき・重み・ユニットに注目します
アーリーストッピングは、検証データでの成績を見ながら、学習を早めに打ち切る方法です。実際には、一度悪化しただけで止めず、一定回数改善しなければ止めるなどの設定をします。
重みに罰則を加える正則化では、予測のずれに加え、重みの大きさも評価するようにします。たとえば、大きな重みほど罰則を増やします。学習データに合わせすぎないよう、重みに制約をかける考え方です。
ドロップアウトは、学習中に一部のユニットの出力をランダムに0にする方法です。特定のユニットだけに頼るのを抑えます。通常の推論では、このランダムな無効化を行いません。学習時と推論時で値の大きさがずれないよう、倍率も調整します。
なお、正則化は過学習を抑える工夫全般を指す場合もあります。アーリーストッピングやドロップアウトも、その一つに数えられます。この記事では、区別しやすいように「重みに罰則を加える正則化」と書き分けています。
3つは、同時に使うこともできます。共通する目的は、新しいデータでも予測できるモデルにすることです。
転移学習は、学習済みモデルを別の課題に生かす方法です
転移学習では、すでに学んだ知識を新しい課題に利用します。たとえば、さまざまな写真で学んだモデルを、花の種類の判定に使います。最初から学習する場合に比べ、少ないデータや計算で済むことがあります。
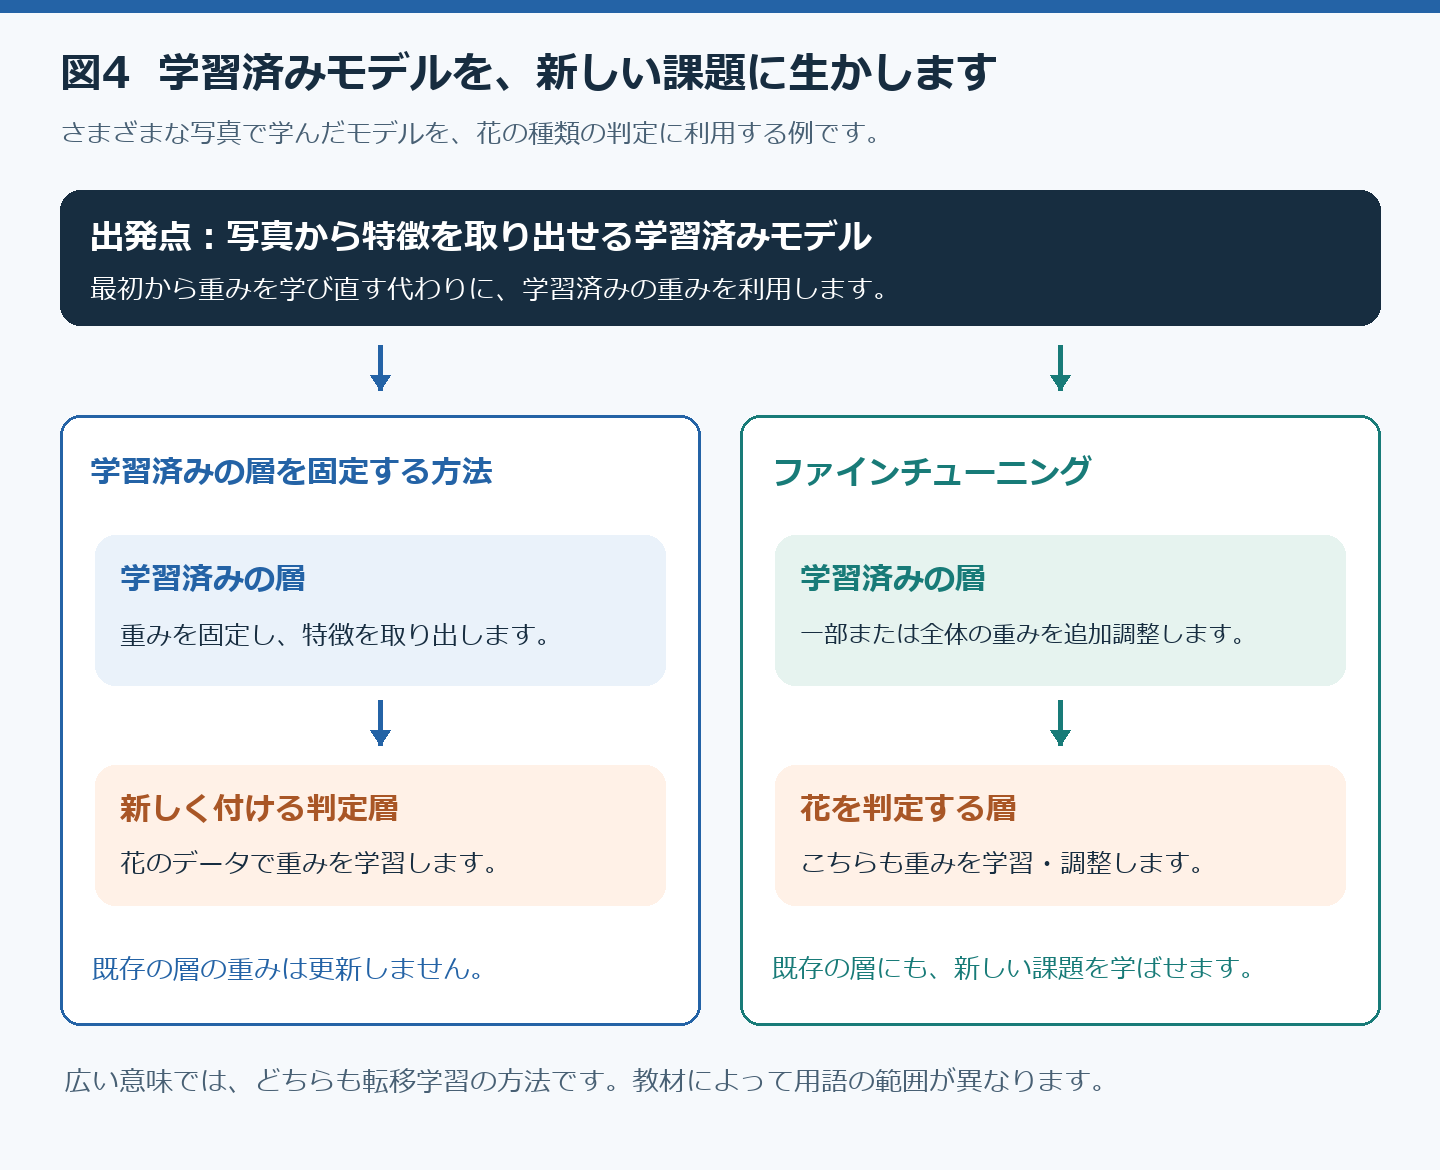
一つの方法は、学習済みの層を固定し、花の種類を判定する新しい層だけを学習するやり方です。固定した層は、写真の特徴を取り出すために使います。
ファインチューニングでは、学習済みの重みの一部または全体も、新しいデータに合わせて追加調整します。広い意味では、これも転移学習の方法の一つです。
教材によっては、既存の層を固定する方法を「転移学習」と呼び、ファインチューニングと対で説明します。用語だけで判断せず、どの層の重みを更新するかに注目すると整理できます。
LLMのファインチューニングは、第2章にも登場します。具体的な進め方は、連載の第4回で扱います。
チャットAIに、過学習の対策を出題させます
次の文を、使っているチャットAIに送ってみてください。
過学習を、試験勉強のたとえで3文で説明してください。そのあと、アーリーストッピング・正則化・ドロップアウトのどれに当たるかを当てる問題を、名前を伏せて1問ずつ出してください。私が答えたあとで正解を教えてください。私がChatGPTで試したときは、3問がまとめて出ました。答えを送ると採点してくれて、3問とも正解でした。
「正則化」と答えた問題は、罰則を加える方法を指すのか、対策全般を指すのかも確かめます。AIの解説と図3が食い違ったら、学習の止めどき・重みへの罰則・ユニットの無効化のどれを説明しているかを見直してください。
確認問題で、学習・過学習・転移学習を確かめます
以下は、この記事の復習用に作った問題です。
Q1. 誤差逆伝播法の説明として正しいものはどれですか。
- A. 予測と正解のずれを、1つの数にします。
- B. 出力側から前の層へさかのぼり、重みごとの勾配を求めます。
- C. 勾配と学習率を使い、重みを更新します。
- D. 各ユニットで、計算した値を変換します。
答えはBです。Aは損失関数、Cは勾配降下法、Dは活性化関数の説明です。
Q2. 学習データでは正解率が高いのに、新しいデータでは低いモデルがあります。状態と対策の組で正しいものはどれですか。
- A. 過学習に対して、ドロップアウトを使います。
- B. 過学習に対して、学習データの正解率だけを見て学習を続けます。
- C. 勾配消失に対して、重みに罰則を加えます。
- D. 汎化を防ぐために、アーリーストッピングを使います。
答えはAです。ドロップアウトは過学習を抑える方法の一つです。Bの進め方では、新しいデータでの成績を見落とします。Cの勾配消失は、勾配が小さくなり、学習が進みにくくなる問題です。Dの汎化は防ぐ対象ではなく、目指す性質です。
Q3. 学習済みモデルを利用して、新しい課題を学習する例はどれですか。
- A. 一般の写真で学んだモデルを、花の写真で追加学習します。
- B. 花の写真だけを集め、最初から学習します。
- C. 花を判定できる学習済みモデルに写真を入れ、そのまま判定します。
- D. 花の見分け方の規則を、人が書きます。
答えはAです。転移学習の例に当たります。Bは最初からの学習、Cは追加学習をしない推論、Dはルールベースです。
まとめ
ニューラルネットワークの学習では、損失関数でずれを測ります。誤差逆伝播法で勾配を求め、勾配降下法で重みを更新します。
学習データでの成績だけを追うと、過学習を見落とします。検証データでも成績を確かめ、必要に応じて学習の打ち切りや正則化を使います。学習済みモデルを別の課題に生かす考え方が、転移学習です。
後編では、CNN・RNN・LSTM・VAE・GANなどを扱います。連載の順番は、生成AIパスポートの勉強方法にあります。
出典・参考資料(2026年10月17日確認):
- 対象範囲は、生成AIパスポート試験シラバスを確認しました。
- 活性化関数の役割は、Googleの解説を参照しました。
- 学習の仕組みと罰則による正則化は、Googleの誤差逆伝播法の解説とL2正則化の解説を参照しました。
- 過学習と対策は、Googleの過学習の解説、KerasのEarlyStopping、Dropout原論文を参照しました。
- 転移学習とファインチューニングは、Kerasの解説を参照しました。

コメント